Google知识图谱与实体SEO:AI平台如何识别你的品牌身份

Google知识图谱与实体SEO:AI平台如何识别你的品牌身份
Gartner预测,到2026年传统搜索量将下降25%,但包含超过1.6万亿条事实、覆盖540亿个实体的Google知识图谱,对大多数营销人员来说仍是一片盲区。如今AI助手带来的流量转化率比传统搜索高出23倍,品牌一旦被这些助手忽略,损失将相当可观。在这篇文章里,innflows会带你了解:AI平台如何识别并确认你的品牌作为一个"实体"存在、它们信任哪些来源进行验证,以及如何衡量你的品牌在ChatGPT和其他主流AI助手中的知识图谱表现。
什么是Google知识图谱,为什么它驱动着AI搜索
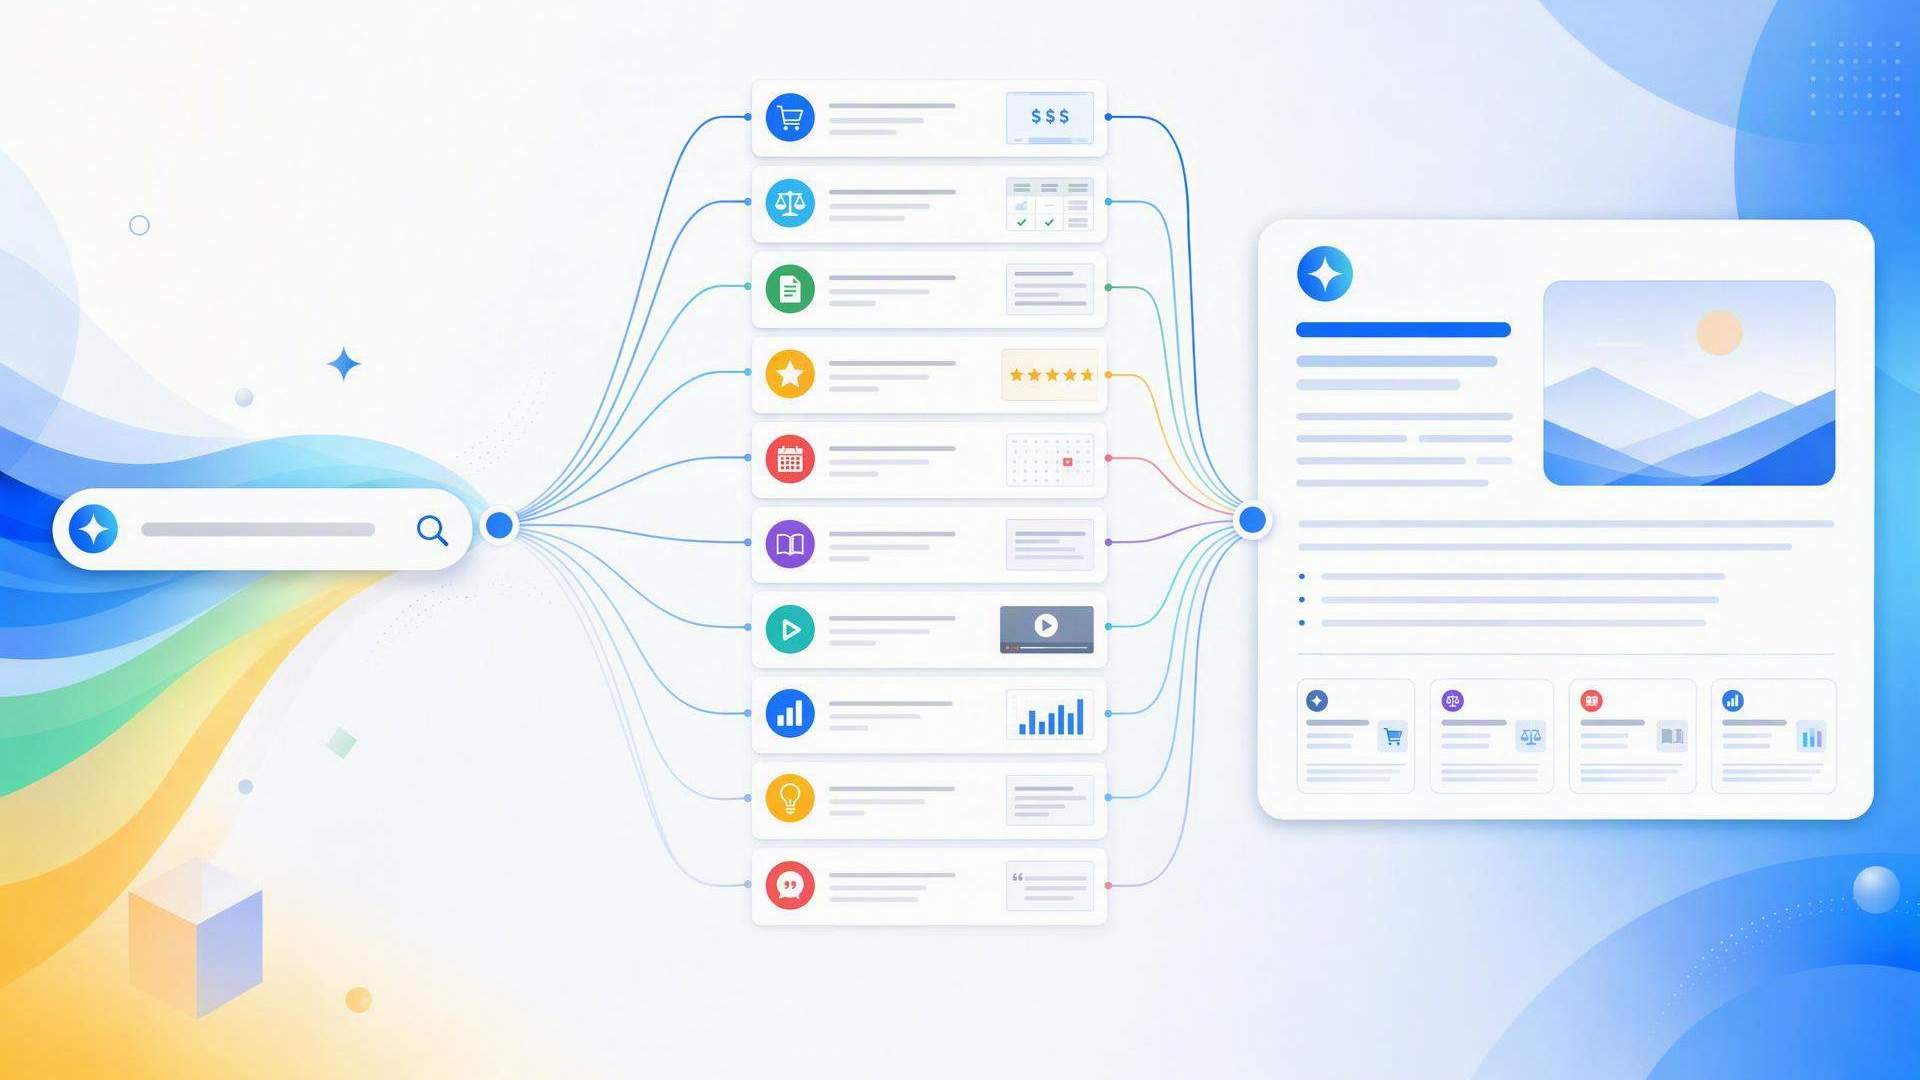
Google于2012年5月16日推出知识图谱,目标是让搜索从"匹配字符串"转向"理解事物"[1]。Google知识图谱本质上是一个结构化数据库,其中真实存在的实体以"节点"的形式存在,"关系"将它们连接起来并描述彼此如何互动。每个节点代表一个独立实体(人物、地点、组织或概念),而边则定义了实体之间的语义连接[2]。
知识图谱的结构:实体、关系与属性
知识图谱SEO的底层架构依赖三个核心组件,让机器能够结合语境处理信息。实体是最基本的构建单元,通过独特的标签和属性与相似概念区分开来[3]。举个例子,当Google处理"seal"这个搜索词时,知识图谱优化系统能判断用户想了解的是海豹这种海洋哺乳动物、英国那位歌手,还是美国海军的特种作战部队[1]。
关系是实体之间的连接组织,建立起有向或无向的关联。有向关系表达的是"John在Google工作",而无向关系表达的是"John和Mary是朋友"[3]。属性则为实体增添描述性的层次,提供有助于AI平台在不同语境中区分相似词汇的特征信息[4]。
本体(Ontology)负责组织Google中的实体,提供一致定义属性和关系的正式框架[1]。资源描述框架(RDF)三元组以"主语-实体-宾语"的形式构建知识,让系统能够通过遍历相互连接的实体关系,回答诸如"麦当娜出生在哪里?"这样的问题[5])。
Google知识图谱自2012年以来的演变
最初发布时,知识图谱包含超过5亿个对象和35亿条事实[1]。仅仅七个月后,数据规模就翻了三倍,覆盖5.7亿个实体和180亿条事实。到2016年年中,Google宣称已掌握700亿条事实,能够回答它每月处理的1000亿次搜索中约三分之一的查询。这一系统持续扩张,到2020年5月已达到50亿个实体上的5000亿条事实[5])。
Google从多个验证来源构建了这套知识库,包括维基百科、CIA世界概况(已于2026年2月停止更新)、Freebase,以及提供体育比分和股价的授权数据商[5])[6]。后来,平台又纳入了从已索引网页中提取的RDFa、Microdata和JSON-LD内容,并用Schema.org词汇表来组织实体类型[2]。
知识图谱在AI概览、Gemini和AI模式中的作用
Google自家的知识图谱负责生成AI概览(AI Overview)的回答,已成为公司各类AI产品的基础设施[7]。知识图谱通过打通人、内容和交互之间的数据来增强Gemini,从而改善实体识别、关系映射和意图理解[8]。
Google的AI模式(AI Mode)会在调用实时网页结果的同时借助知识图谱,由此获取仅靠网页爬取无法干净提供的、关于实体的结构化事实数据。当用户搜索"《盗梦空间》导演的其他电影"时,AI模式会沿着知识图谱中相互连接的实体,呈现出克里斯托弗·诺兰的完整作品列表[8]。
通过一种被称为"接地"(grounding)的方法,幻觉问题已大幅减少。对于客观或品牌相关的问题,这种方法会将用户提示映射到知识图谱,并从相应组织检索事实[7]。知识图谱将生成式AI的输出锚定在结构化、相互关联的数据上,降低了产生错误信息的概率。通过把数据组织成节点和边,知识图谱为深度学习模型提供了消除概念歧义所需的语境框架,使其能够基于相互连接的数据源给出连贯的回答[9]。
实体SEO对比传统关键词SEO:一场根本性转变
搜索引擎不再只是匹配文本字符串,而是通过命名实体识别(NER)来辨认实体。NER是自然语言处理中的一个组件,负责把文本中的关键部分归入预定义的类别。这一分类过程把非结构化内容转化为AI平台可以处理和解读的结构化数据。
搜索引擎如何识别和分类实体
当Google爬取你的内容时,NER算法会提取并分类以下几类特定信息:
- 人物:诸如"Sundar Pichai"或"Dr. Jane Doe"这样的个人姓名
- 组织:公司、机构和政府机关,如"Google"或"世界卫生组织"
- 地点:地理位置、地址和地标,包括"纽约"或"巴黎"
- 日期与时间:具体的时间表达,如"昨天"或"2025年5月5日"
- 产品:具体的商品或服务,如"iPhone"或"Google Cloud"
- 事件:有名称的事件,包括会议、战争或节庆 [10]
在处理查询时,搜索引擎会识别你搜索词背后的主题本体,并据此筛选出一批合适的内容结果。面对含义模糊的词汇,语境就变得至关重要——Google只有结合实体之间的关系语境,才能回答关于这些实体的问题。搜索引擎会在后台用语义标注和查询改写来重写搜索词,去解读其含义,而非单纯匹配关键词[11]。
为什么关键词匹配在生成式搜索中失灵
传统关键词研究是为一个已经不复存在的系统打造的。搜索量指标存在48%到62%的误差率,排名也不再与流量挂钩[12]。说到底,基于关键词的搜索匹配的是词,而不是意义[7]。
查询长度的差异把这种错位暴露得淋漓尽致。传统搜索查询平均3到4个词,而AI搜索查询平均长达23个词。这些对话式的问题表达的是关键词框架无法应对的复杂意图。超过70%的AI搜索查询并不符合"信息型"或"交易型"等传统意图分类[12]。
AI驱动的意图匹配在识别用户意图上的准确率高达85%,而基于关键词的系统只有60%到70%。即使内容中没有出现确切的关键词,AI也能通过语义搜索和语境分析理解其含义[12]。这意味着,一篇关键词堆砌得再完美的内容,在以意图(而非词汇)进行匹配的AI平台面前,仍可能是隐形的。
一项分析了2.5万次用户搜索的研究发现,在Google上排名第一的网站,只有25%的概率会出现在AI的回答里。尽管76%的AI概览引用来自Google前十名的页面,但传统排名只是必要条件,而非充分条件。AI平台对品牌信号的权重,要高于反向链接或域名权威度[12]。
商业影响:AI搜索流量的转化率
AI驱动的平台带来的引荐流量增长了155.6%,远超搜索(24.0%)和社交(21.5%)的增幅。尽管AI引荐流量在整体流量中占比不到1%,其转化率却更高[13]。
Copilot的引荐带来了最高的订阅转化率,达到直接流量的17倍、搜索流量的15倍。Perplexity以7倍的转化率位居第二,Gemini为4倍[13]。在Ahrefs,AI搜索访客的转化率比传统自然搜索访客高出23倍[14]。
另有分析显示,ChatGPT的转化率达到16%,而Google自然搜索仅为1.8%。各平台细分来看:ChatGPT为15.9%,Perplexity为10.5%,Claude为5%。ChatGPT流量的参与度也更高,用户每次会话浏览超过2个页面,而自然搜索仅为1.2个[8]。
在被分析的1,277个域名中,超过半数(52%)在过去一个月已经将来自AI模型的流量转化为注册或订阅[13]。截至2025年第四季度,AI搜索流量约占网站引荐总流量的1%,但同比增速高达527%[6]。
AI平台如何把你的品牌识别为一个实体
AI模型在处理品牌名称时,往往会遇到成千上万个可能的匹配项。命名实体消歧(named entity disambiguation)正是用来解决这一身份难题的——它通过权衡语境信号,从多个候选项中挑出正确的实体。比如当AI平台在B2B语境中看到"Apollo"时,它必须判断你指的是阿波罗登月计划、希腊神话中的太阳神,还是那家销售情报平台。一旦缺乏清晰的消歧信号,模型要么默认指向最常见的那个实体,要么为了规避幻觉风险干脆不提你[1]。
实体识别与消歧的过程
Google的自然语言处理系统会运行实体提取,识别内容中提到的人物、地点、组织和概念。每个被提取的实体都会获得一个0到1之间的显著性评分(salience score),用来衡量它对内容的核心程度。评分越高,关联越强。随后,系统会把提取出的实体映射到知识图谱的节点上,将你的内容接入更广阔的实体网络[9]。
EAV-E公式:实体-属性-值-证据结构
EAV-E公式专为大语言模型(LLM)的检索而设计,用来组织信息[1]。实体(Entity)界定主体(你的公司、产品或功能);属性(Attribute)说明你所声称的特性或能力;值(Value)给出具体、可量化的细节;证据(Evidence)则提供验证该主张的来源。
与其写"我们提供快速部署",不如这样写:"Innflows〔实体〕在24小时内〔值〕交付AI可见度审计〔属性〕,并有客户项目日志和合同为证〔证据〕"[1]。这种结构能降低"幻觉惩罚",因为AI模型会避免做出无法核实的陈述。当你的内容遵循EAV-E时,模型可以把每一条主张追溯到证据,从而让引用变得更安全[1]。
在各平台间建立一致的NAP信号
在所有地方都使用完全一致的NAP(名称Name、地址Address、电话Phone)。如果你的LinkedIn写的是"Acme Software Inc.",官网写的是"Acme",而G2上又是"Acme Software",AI模型很可能会把它们当作不同的实体来对待。因此,请在各平台使用完全相同的"关于我们"标准文案:撰写一段2到3句的标准公司简介,原封不动地发布在官网、LinkedIn、Crunchbase、G2以及任何出现你品牌的地方[1]。
Schema标记:Organization、Product与sameAs属性
Schema.org标记为AI的知识图谱提供了一条直达通道。Organization(组织)schema把你的公司定义为一个独立实体,包含名称、logo、URL、联系方式,以及指向权威资料页面的sameAs属性。Product(产品)schema用品牌、描述、价格和总评分等具体属性来映射你的产品。sameAs数组则告诉AI模型:所有这些资料页面指向的是同一个实体,从而让它们能够带着信心从多个来源拉取信息[1]。
AI模型信任的第三方验证来源
AI模型通过交叉比对一系列结构化知识库来验证品牌实体,这些知识库扮演着"权威事实层"的角色。正是这些验证来源,决定了你的品牌是出现在生成式回答中,还是彻底隐形。
维基数据与维基百科作为验证来源
维基百科是每一个主流大语言模型的训练数据,按影响力权重计算约占模型训练数据的22%。Google知识图谱中关于50亿个实体的5000亿条事实,很大一部分正是从维基百科和维基数据"播种"而来[4]。维基百科跨越300多种语言,是AI平台解析的最大开放信息语料库之一[15]。
维基数据则充当着结构化数据的骨干。截至2025年初,它已包含16.5亿条项目陈述。包括Siri和Alexa在内的虚拟助手都会从维基数据中拉取实体信息[16]。这个平台链接着2,000多个其他知识库,扮演着通用标识符枢纽的角色[17]。如果你没有维基数据条目,你的品牌就缺少了AI模型用来解析实体查询的那个结构化参照点。
商业数据库:Crunchbase、LinkedIn与G2
Crunchbase提供包括融资事件、收购和新闻报道在内的公司数据,是AI模型进行B2B实体验证时的参考来源。G2 Seller Solutions则在各类数字平台上提供客户反馈和评价管理[18]。这些数据库补充了维基百科无法提供的交易型和关系型数据。
Reddit、论坛与社区驱动的实体信号
大语言模型把Reddit和论坛内容当作高密度训练数据来处理,从中提取真实的用户情感和实际使用案例[19]。Reddit每月6亿多活跃用户产生的体验性语境,是企业官网所欠缺的。自2024年起,Google就在搜索结果中优先展示Reddit内容,尤其是在产品推荐方面[20]。AI搜索引擎之所以青睐论坛数据,是因为这些点对点的体验式讨论,比营销文案能获得更高的语境嵌入得分[19]。
在多个平台间建立实体共识
AI模型会跨来源对实体信息进行三角验证。一旦维基百科、Crunchbase、LinkedIn和你自有资产之间出现不一致,就会制造不确定性,从而降低引用的置信度[21]。你需要在所有平台上保持完全一致的描述,向AI模型传递它们进行有信心引用时所需要的实体共识信号。
衡量品牌在知识图谱中的存在感
知识图谱存在感的追踪,已经超越了传统的流量指标,转向以"引用"为核心的衡量框架。引用率(Citation Rate)量化的是:当AI平台回答相关品类问题时,你的品牌出现的频率。你应当追踪50到200个代表客户调研旅程的购买决策问题,然后计算其中提及你品牌的比例。举例来说,如果你的品牌在100个被追踪的查询里出现了18次,那么你的引用率就是18%[22]。
用知识图谱API核查实体状态
Google的知识图谱搜索API(Knowledge Graph Search API)允许你查询实体的识别状态。该API以JSON-LD格式返回实体类型分类、相关性评分、schema类型和关联描述[23]。其中的resultScore反映了Google对该实体的理解置信度,分数越高,代表实体识别越牢固[11]。你可以借助这个API来确认:Google是否已将你的品牌识别为一个独立实体,或是否存在消歧问题[24]。
ChatGPT、Claude与Perplexity中的引用频率
AI搜索无法被当作一个整体来优化,因为每个平台对来源的权重设定各不相同[25]。Superlines在2026年3月的分析记录到,同一个品牌在不同平台之间的引用量差异最高可达615倍[26]。ChatGPT偏好维基百科提及和适配Bing的结构;Claude要求正式的引用和技术上的精确;Perplexity则青睐真实的Reddit参与和时效性信号[25]。
声量份额:追踪竞争对手的实体可见度
声量份额(Share of Voice)的计算方式是:用你的引用次数除以该品类的总引用次数,再乘以100。如果AI在回答"顶级CRM平台"时列出了五家竞争对手却没提到你,那么你的声量份额就是0%。你应当针对前三名竞争对手来计算这一指标,因为竞争差距比绝对引用率更值得关注[25]。简单公式为:(你的品牌提及次数 ÷ 品类总提及次数)× 100[10]。
AI归因流量与转化指标
AI引荐流量的转化率远高于自然搜索。有分析显示,AI流量的转化率为14.2%,而Google为2.8%。这一点意义重大——它意味着每一次引用的价值,约相当于传统自然访问的5倍[22]。各平台的转化率各异:ChatGPT为15.9%,Perplexity为10.5%,Claude为5.0%,Gemini为3.0%[6]。被AI概览引用的网站,其自然点击率高出35%,付费点击率高出91%[22]。尽管AI引荐仅占总流量的1%,其转化表现却明显更胜一筹[6]。你可以用能识别具体AI平台的UTM来源标签,来追踪试用和演示申请[25]。然而截至2025年10月,只有16%的品牌在追踪自己的AI搜索表现[6]。
结语
我们梳理了AI平台如何通过Google知识图谱来识别和验证你的品牌。搜索已经从关键词匹配转向了实体识别。趋势非常清晰:AI搜索流量的转化率比传统自然搜索高出23倍,而追踪这一表现的品牌却只有16%。
如今,你品牌的可见度取决于来自维基百科、维基数据、Crunchbase的结构化实体信号,以及一致的NAP数据,而不再是关键词密度。EAV-E公式和Schema标记,提供了AI模型在引用你品牌之前所需要的那套验证框架。
从今天起,开始衡量你的引用率和声量份额吧。那些现在就着手建立实体共识的品牌,将率先赢得竞争优势。如果你希望系统地为AI搜索引擎优化内容、提升品牌在生成式回答中的可见度,innflows可以帮你把这套方法落到实处。
常见问题
Q1. 什么是Google知识图谱,它是如何运作的?
Google知识图谱是一个结构化数据库,它把关于现实世界实体(人物、地点、组织、概念)的信息组织成相互连接的节点。它包含超过1.6万亿条事实、覆盖540亿个实体,让搜索引擎能够理解事物之间的关系,而不只是匹配关键词。这套系统通过提供对实体及其关联的语境理解,驱动着AI搜索。
Q2. 实体SEO与传统的基于关键词的SEO有何不同?
实体SEO的重点在于通过结构化数据和跨平台的一致信号,把你的品牌确立为一个被识别的实体;而传统SEO依赖的是关键词匹配。如今搜索引擎使用命名实体识别,基于含义和语境来识别和分类内容,而非依靠确切的关键词匹配。这一转变至关重要,因为AI搜索查询平均长达23个词,而传统搜索仅3到4个词,这要求语义理解而非关键词密度。
Q3. AI平台用哪些来源来验证和确认品牌实体?
AI平台主要依赖维基百科和维基数据作为基础验证来源,其中维基百科约占模型训练数据的22%。它们还会交叉比对Crunchbase、LinkedIn和G2等商业数据库以获取公司信息,并参考Reddit和论坛等社区驱动的来源,以获得真实的用户情感和现实世界的语境。所有这些平台之间的一致性,会形成提升引用置信度的实体共识。
Q4. 我该如何衡量品牌在知识图谱中的存在感?
你可以通过多种方法衡量知识图谱存在感:使用Google知识图谱搜索API核查实体识别状态;通过监测品牌在AI生成回答中针对相关查询出现的频率来追踪引用率;针对竞争对手计算声量份额;以及衡量AI归因流量的转化率。由于ChatGPT、Claude和Perplexity对来源的权重各不相同,各平台的引用频率也应分别监测。
Q5. 为什么AI搜索流量比传统自然搜索转化得更好?
AI搜索流量转化率显著更高,是因为提出详细、对话式问题(平均23个词)的用户意图更强,且在调研旅程中走得更靠后。AI引荐访客的转化率为14.2%,而传统自然搜索为2.8%,各平台的转化率从3%(Gemini)到15.9%(ChatGPT)不等。这些用户的参与度也更高,每次会话浏览超过2个页面,而自然搜索仅为1.2个。
参考资料
[2] - https://en.wikipedia.org/wiki/Knowledge_graph
[3] - https://www.splunk.com/en_us/blog/learn/knowledge-graphs.html
[4] - https://ziptie.dev/blog/how-wikipedia-like-sources-shape-ai-answers/
[5] - https://en.wikipedia.org/wiki/Knowledge_Graph_(Google)
[6] - https://www.growthmarshal.io/field-notes/ai-search-traffic-is-4x-more-valuable-than-organic
[9] - https://www.stackmatix.com/blog/entity-based-seo-topical-authority
[10] - https://www.talkwalker.com/blog/measure-share-voice
[11] - https://www.searchenginejournal.com/google-knowledge-graph-search-api/464370/
[12] - https://www.onely.com/blog/why-traditional-keyword-research-fails-in-ai-search/
[13] - https://clarity.microsoft.com/blog/ai-traffic-converts-at-3x-the-rate-of-other-channels-study/
[14] - https://ahrefs.com/blog/ai-search-traffic-conversions-ahrefs/
[15] - https://wikimediafoundation.org/news/2023/07/12/wikipedias-value-in-the-age-of-generative-ai/
[16] - https://en.wikipedia.org/wiki/Wikidata
[17] - https://ital.corejournals.org/index.php/ital/article/download/10886/9483/21365
[18] - https://www.cuspera.com/compare/crunchbase-enterprise-vs-g2-seller-solutions/1137/5532
[19] - https://semai.ai/blogs/the-role-of-reddit-and-forums-in-ai-brand-mentions/
[23] - https://developers.google.com/knowledge-graph
[24] - https://audits.com/tools/knowledge-graph-search/
[26] - https://authoritytech.io/curated/ai-citation-11-percent-platform-overlap-per-engine-audit-2026