AI Crawl-to-Referral:如何衡量 GEO 回流效率
AI 爬虫抓了多少,又带回多少人?Crawl-to-Referral 如何补上 GEO 测量缺口
AI 爬虫每天访问了多少页面?这些访问后来换回了多少真人流量?到站用户有没有继续阅读、提交表单或购买?
过去,这些问题分散在三套系统里:CDN 或服务器日志记录机器抓取,AI 可见度工具记录引用,网站分析与 CRM 记录真人行为。彼此没有对齐,团队只能分别汇报“被抓了多少”“被引用多少”和“AI 流量多少”。
2026 年 8 月,Microsoft Clarity 推出 AI Scrape-to-Referral Ratio,把 AI 抓取活动与转介访问放在同一个分析界面,并允许按运营方查看、下钻到经过筛选的 session recordings。一个多月前,Cloudflare 也上线 Attribution Business Insights,提供站点级与运营方级 crawl-to-referral、带宽消耗以及 Training、Search、Agent 等爬虫角色 [1][2]。
这并没有让 GEO 突然变成可以逐次追踪的线性漏斗,却补上了一个关键缺口:AI 平台取走了多少内容访问,又带回了多少可识别的人类访问。
---
先给结论
Crawl-to-Referral Ratio 可以用来诊断 AI 抓取与真人回流之间的交换效率,但它目前不是统一行业标准,也不是搜索排名因素或完整 GEO ROI。
为了让内部报表口径稳定,本文建议把运营指标定义为:
Crawl-to-Referral(C:R)
= 已验证的成功检索/代理型 HTML 页面抓取请求
÷ 可归因的 AI 真人转介会话
结果写成 X 次抓取 : 1 次转介。在同一站点、同一平台家族、同一时间窗口和同一覆盖范围内,数值越低,通常表示每次机器抓取对应的可识别回流越多。
但必须同时保留另一项指标:
全 AI 内容消耗—回流比
= 全部已验证 AI 页面抓取请求
÷ 可归因的 AI 真人转介会话
它可以反映内容与带宽交换,却不能评价搜索获客效率,因为训练爬虫本来就不以发送访问为直接目标。
最重要的边界有五个:
- 一次抓取不能对应一次引用。 页面可能被缓存、反复用于多个答案,或很久以后才被调用。
- 一次引用不能对应一次点击。 用户可能在答案里完成任务,根本不访问来源网站。
- 爬虫运营方与转介域名未必一一对应。 AI 平台可能使用合作搜索索引或不同抓取基础设施。
- 可追踪转介只是下限。 Referrer 被剥离、复制链接或跨应用跳转,都会让部分访问进入 Direct 或其他渠道。
- 比率只能在口径一致时比较。 域名覆盖、bot 角色、状态码、资源类型和观察窗口任何一项不同,都可能改变结果。
一句话概括:Crawl-to-Referral 不是“抓一次、来一个人”的转化率,而是机器内容消耗与可识别人类回流之间的聚合诊断指标。
---
为什么现在才开始能测
普通前端分析脚本只能记录执行 JavaScript 的浏览器会话,看不到大多数 AI crawler 请求。Microsoft Clarity 的 AI Bot Activity 改用连接 CDN 后获得的服务器端日志,识别已验证 bot、运营方、用途和访问路径;这让“机器实际请求了什么”第一次能与客户端用户行为处在同一分析产品中 [3]。
Clarity 随后又补充了请求总量、AI bot 流量占比、被抓页面比例、状态码、路径和内容类型,并支持包括 Fastly、Amazon CloudFront、Cloudflare、Azure Front Door 与 Akamai 在内的 CDN 接入 [4]。
2026 年 8 月新增的 Scrape-to-Referral Ratio 更进一步:
- 比较 AI scrape activity 与 referral traffic;
- 按 operator 查看谁在抓取、谁在带回访问;
- 只在正确 mapped domains 范围内计算,并提示 CDN 与 Clarity 覆盖不一致;
- 从 AI referral source 直接进入已筛选的 session recordings;
- 观察访客是否滚动、互动、购买、注册、填写表单或快速离开 [1]。
Cloudflare 的 Attribution Business Insights 从网络边缘提供另一种视角:查看 bot 与 human traffic、成功访问内容的 bot 数量、站点与运营方级 crawl-to-referral、带宽、国家、allow/block 状态,并将爬虫按 Training、Search 和 Agent 等用途归类。分析发生在 dashboard,访问控制仍需回到 Security rules 执行 [2]。
两套产品共同推动了一件事:爬虫不再只是安全团队的日志噪声,而开始进入内容、增长和商业谈判的测量体系。
---
不要画成漏斗:应该建立五本账
最容易犯的错误,是把下面五层画成一个每步都可追踪的漏斗:
Crawl → Citation → Referral → Engaged Session → Conversion
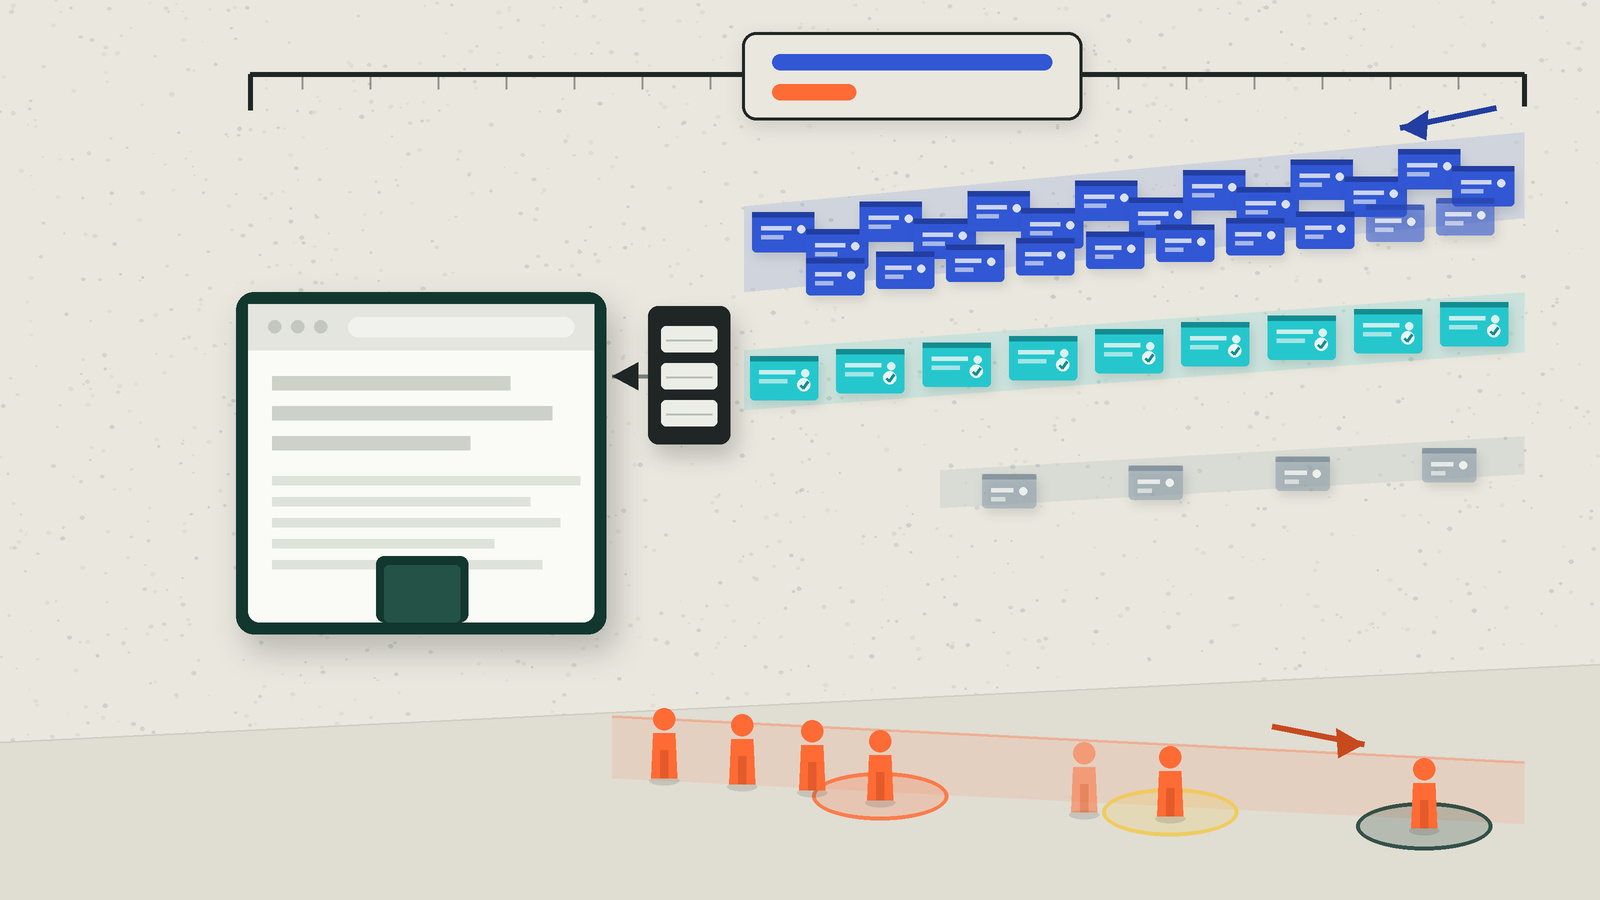
它更准确的名字是五层测量链。每一层有自己的数据源和分母,跨层只能按平台、内容组和时间窗口做聚合关联。
| 层级 | 建议记录什么 | 主要数据源 | 不能代表什么 |
|---|---|---|---|
| 抓取 | 已验证 bot、角色、HTML 请求、状态码、canonical URL、bytes | CDN / WAF / origin logs | 抓取不等于索引或引用 |
| 引用与可见度 | 固定问题集中的品牌提及、引用 URL、引用次数或 citation rate | 平台报表、外部重复测试 | 引用不等于排名、点击或正面推荐 |
| AI 转介 | 可归因到 AI 来源的真人 sessions | GA4、Clarity、服务端分析 | 只是可识别访问下限 |
| 互动会话 | AI sessions 中满足既定互动规则的会话 | GA4、Clarity recordings | 互动不等于商业转化 |
| 转化 | 线索、订单、收入、辅助转化与销售结果 | Analytics、CRM、电商系统 | 不能自动归因给某次抓取 |
Microsoft Clarity 的 Citations 正在尝试把 crawling/indexing、AI 引用和 AI-referred traffic 放进同一套 AI Visibility 体验。但 Microsoft 同时说明,引用数据是支持范围内的代表性聚合视图,不是每个 prompt 与引用的完整日志,更适合趋势比较而非逐条对账 [5]。
这正是为什么五层必须分开:能在同一报表里看到,不等于它们已经形成逐事件因果链。
---
Crawl-to-Referral 应该怎么计算
指标一:全 AI 内容消耗—回流比
全部已验证 AI 页面抓取 ÷ 可归因 AI 真人会话
这个口径回答:“所有 AI 系统一共从网站拿走多少页面请求,网站收到多少可识别人类访问?”
它适合评估带宽、内容许可与平台交换关系,但会把训练、搜索和用户触发型访问放在一起。数值很高不一定说明 GEO 失败,只可能说明训练抓取占比高。
Cloudflare 2026 年报告也强调,训练、搜索和混合用途的爬虫正在改变开放网络的交换结构;其数据来自 Cloudflare Radar 与公司披露的网络观测,应理解为特定网络范围内的厂商统计,而不是所有网站的统一基准 [6]。
指标二:检索型 Crawl-to-Referral
已验证的成功 Search / Agent HTML 抓取
÷ 对应平台家族的可归因 AI 真人会话
建议只统计:
- 已验证 operator;
- Search、RAG indexing 或 Agent 角色;
- 返回 2xx 的 HTML GET;
- 去除图片、CSS、JavaScript、重复重试和明显资产请求;
- 统一 canonical URL 与 mapped-domain 范围。
平台映射不确定时,不要强行把某个 crawler 与某个 referrer 配对。建立 unmapped 分组,比制造虚假精确度更可靠。
指标三:每千次检索抓取的转介产出
对业务团队而言,反向表达更直观:
Referral Yield per 1,000 Crawls
= 可归因 AI 真人会话
÷ 成功检索型 HTML 抓取 × 1,000
这个数字越高,表示每千次检索型抓取对应的可识别转介越多。它与 C:R 使用同一批数据,只是方向相反。
指标四:回流后的质量
抓取换来访问之后,还要继续看:
AI Referral Engagement Rate
= AI-referred engaged sessions ÷ AI referral sessions

AI Referral Conversion Rate
= AI-attributed converting sessions ÷ AI referral sessions

Revenue per AI Referral Session
= 可归因收入 ÷ AI referral sessions
GA4 将 engaged session 定义为满足至少一项条件的会话:超过 10 秒、发生 key event,或至少产生两次页面/屏幕浏览;互动计时阈值可以在属性中调整 [7]。
因此,跨公司比较 engagement rate 前,必须确认事件、阈值与属性配置一致。
---
一套可执行的 30 天基线
第一步:冻结范围
先确定:
- 统计哪些域名与子域名;
- 哪些地区、语言和内容目录;
- 使用 28 天还是 30 天滚动窗口;
- 哪些 operator 与 referral host 属于同一平台家族;
- Search、Training、Agent 与 Unknown 如何分类。
Clarity 特别提示 mapped domains 不一致会扭曲 scrape-to-referral,因此覆盖范围必须在看数字前先对齐 [1]。
第二步:清洗抓取分子
不要直接使用所有请求总量。至少拆分:
- verified 与 unverified;
- HTML 与静态资产;
- 2xx、3xx、4xx、5xx;
- 唯一 URL 与重复请求;
- Training、Search、Agent、Unknown;
- 页面请求数与传输 bytes。
这样才能判断比率变差是爬虫突然重试、错误页面增加,还是内容需求真的上升。
第三步:记录引用层
用固定业务问题集,按平台和语言持续记录:
- 是否提及品牌;
- 是否引用本站;
- 引用了哪个 URL;
- 以什么角色出现;
- 同类答案中哪些竞品被引用。
引用层不能从抓取日志直接推出,但它能解释“抓取很高、回流很低”究竟发生在哪一段。
第四步:清洗真人转介
维护 AI referral 来源表,保留 session source、referrer、UTM、landing page、设备、地区和新老用户。Bot sessions 必须排除,无法确认的访问留在 Unattributed,不要按比例硬分给 AI。
GA4 的 session source 受 non-direct last-click 与 lookback 设置影响;直接回访可能继承之前的非直接来源,因此报表必须固定归因设置,并在需要精确分析时使用 BigQuery 或服务器端数据复核 [8]。
第五步:接入互动与转化
把 AI referral sessions 接到:
- engaged sessions;
- 关键二跳页面;
- 表单、注册、试用和下载;
- CRM 合格线索;
- 订单、收入与毛利;
- 首次触点与辅助转化。
直接转化和辅助影响应分开,不能把所有后续收入都记给 AI。
第六步:测试时间滞后
分别比较 0–7 天、8–21 天和 22–45 天的变化。页面可能先被抓取、再进入索引、后来才被答案引用;一次抓取也可能长期服务多个回答。
如果不同滞后窗口都看不到稳定关系,就不要用同月相关性讲因果故事。
---
五种数据组合,分别该找谁
| 观测组合 | 优先解释 | 首先负责的团队 |
|---|---|---|
| 抓取高、引用低 | 先拆 bot 角色;再查解析、证据质量与来源选择 | 技术 SEO / 内容 |
| 引用高、转介低 | 可能是零点击、链接位置、答案已满足需求或不可点击引用 | GEO / 平台分析 |
| 转介高、互动低 | 落地页与答案意图错位、速度或设备体验问题 | 增长 / UX |
| 互动高、转化低 | 报价、表单、信任、产品适配或销售跟进问题 | 产品 / 销售 |
| 抓取低、引用高 | 可能来自缓存、旧抓取、合作索引或第三方来源 | 数据 / 平台研究 |
这张表的价值,是避免把所有问题都归咎于“内容不够 GEO”。
一篇文章被大量抓取却不被引用,和一篇文章被引用却没人点击,是两个完全不同的故障。前者发生在检索与证据选择,后者可能只是平台界面和用户行为。
---
Crawl-to-Referral 不是 GEO ROI
C:R 只比较内容访问与可识别回流。它没有计算:
- 内容生产与更新成本;
- CDN、带宽和反爬基础设施成本;
- GEO 工具与团队成本;
- 线索质量、订单、毛利;
- 没有点击但影响品牌认知的答案曝光。
如果要计算直接回报,可以另建:
Direct AI Referral ROI
=(AI 可归因毛利 − 可归属内容、工具与基础设施成本)
÷ 可归属成本
零点击品牌影响、辅助转化和销售周期中的早期触点应单独报告。没有实验、匹配 cohort 或可靠归因设计时,不要把它们折算成“估算收入”再塞进 ROI。
同样,AI referrals ÷ observed citations 不能随意叫 CTR。没有 citation impressions 和真实 link-click 数据时,它最多是一项不同采样范围之间的聚合 referral yield。
---
Innflows 在这里解决什么
Crawl-to-Referral 的完整测量需要三类数据:服务器/CDN 抓取日志、AI 答案与引用、网站和 CRM 的真人行为。
Innflows 更适合补齐中间的 AI 可见度层:围绕稳定业务问题,跨平台、跨语言持续记录品牌是否出现、引用哪些 URL、竞品占据哪些答案位置,并形成可重复的时间基线。
企业可以把这些结果与自己的 Clarity、Cloudflare、GA4 和 CRM 数据连接成:
机器访问了什么 → AI 答案用了什么 → 真人点击了什么 → 到站后完成了什么
边界必须明确:Innflows 不能读取企业未授权的 CDN 日志或平台内部检索日志,也不能把某次抓取与某次引用、点击逐一绑定。它的作用是让引用层不再缺失,并帮助团队判断问题出在抓取、引用、回流还是转化。
---
六个最常见的误读
1. C:R 越低,GEO 一定越好
不一定。平台界面、缓存、用户意图和归因缺失都会影响转介;比率只适合同口径趋势比较。
2. 训练爬虫回流少,说明平台没有价值
训练抓取本来就不以实时 referral 为目标。它应进入内容交换与许可分析,不应混入检索获客 KPI。
3. 抓取量上涨就是 AI 可见度上涨
不是。抓取之后还有索引、检索、重排、证据选择和答案生成。高抓取只能证明访问需求上升。
4. Clarity 或 Cloudflare 可以还原完整用户旅程
不能。它们能连接更多聚合信号,但无法证明某一次 bot request 最终对应哪一个用户答案和会话。
5. 不同网站可以直接比较 C:R
不建议。内容类型、bot 政策、CDN 覆盖、用户规模、referrer 保留和平台组合不同,都会改变分子与分母。
6. 本月抓取和本月转介同步上涨就是因果
只能说明同期变化。需要稳定基线、时间滞后、内容变更记录和必要的对照设计。
---
常见问题
Crawl-to-Referral 是官方统一指标吗?
不是。Cloudflare 和 Microsoft 都提供抓取与转介的对照能力,但产品口径、覆盖范围和数据源不同。企业应先写清自己的公式与过滤规则。
分子应该用所有 AI bot 请求吗?
用于内容交换分析时可以;用于搜索回流效率时不应该。运营 KPI 应优先使用已验证 Search/Agent 角色的成功 HTML 页面请求,并单列 Training 与 Unknown。
为什么要按 operator 而不是单个 bot 比较?
同一公司可能运行多个 bot,搜索、训练和代理访问也可能分开。Operator 便于做商业判断,但仍需要保留 bot role,避免把不同目的合并。
有引用但没有转介,是不是 GEO 没价值?
不是。答案可能已经满足用户需求,也可能没有醒目的可点击链接。应同时查看品牌角色、引用覆盖和后续业务指标,而不是只看点击。
只用 GA4 能算这个指标吗?
不能。GA4 主要看到真人会话,看不到多数服务器端 crawler 请求。至少需要 CDN/WAF/origin logs 与网站分析两端数据。
多久看一次比较合适?
日数据适合排错,不适合定结论。运营上可使用 28 或 30 天滚动窗口,并额外测试不同时间滞后。
---
核心结论
Crawl-to-Referral 的价值,不是创造一个新的漂亮比率,而是迫使 GEO 团队把四本长期分离的账接起来:
- 机器抓取了多少;
- AI 答案实际用了多少;
- 平台带回多少真人;
- 这些人产生了什么业务结果。
它能帮助企业判断:某个平台是在高频消耗内容、建立答案可见度,还是已经形成高质量获客渠道。
但它不能替代引用测量、用户行为分析和 CRM 归因,也不能把聚合相关性包装成逐次因果。
真正成熟的 GEO 报表,不只回答“AI 看见我了吗”,还要回答“它取走了什么、带回了谁,以及这些访问最终创造了什么”。
---
参考来源
[1] - See Which AI Crawlers Drive Real Website Visits — Microsoft Clarity,2026 年 8 月 13 日
[2] - Unmasking the Crawls with Attribution Business Insights — Cloudflare,2026 年 7 月 1 日
[3] - See AI Bot Activity with Clarity — Microsoft Clarity,2026 年 1 月 22 日
[4] - New Ways to Measure Bot Activity in Clarity — Microsoft Clarity,2026 年 5 月 26 日
[7] - GA4 Engagement Rate and Bounce Rate — Google Analytics Help