为什么视觉内容在 2026 年对大语言模型搜索可见度至关重要

多模态GEO时代:视觉内容如何重塑2026年AI搜索可见性
LLM搜索已从纯文本查询演变为多模态生态系统,视觉内容对AI可见性的影响力已与传统关键词不相上下。Google Lens每月处理200亿次搜索,这一数据明确揭示了图像、视频和产品视觉内容如何训练AI对品牌语境的理解。这一转变带来了一个常被忽视的关键点:视觉资产生成语义信号,直接决定你的品牌是否出现在AI生成回答中。生成引擎优化(GEO)现在需要视觉优化策略,以及AI搜索跟踪来衡量效果。掌握机器可读的视觉内容,决定了在AI引擎优化(AEO)中的竞争优势。
LLM搜索如何转向多模态AI
搜索行为已发生根本性变化。用户不再仅依赖输入关键词来查找信息。相反,他们用摄像头对准产品、拍摄物品照片,并结合视觉输入与语音命令来查询AI系统。
视觉查询正在取代纯文本搜索
视觉搜索解决了一个基本痛点:将所见之物转化为恰当文字的困难。超过50%的消费者现在认为在线购物时视觉信息比文字更重要[1]。这一偏好反映了人们与搜索引擎互动方式的更广泛转变。与其猜测酒店大堂里看到的灯具的关键词,用户直接拍摄物品照片,让AI识别匹配项。
该技术通过创建特征向量(图像关键特征的数学表示),然后将其与已知图像数据库进行比较来工作[1]。搜索引擎现在以视觉方式而非纯文本方式索引世界,回答那些难以用语言描述的查询。
年轻人群推动着这一趋势的普及。约62%的千禧一代更喜欢视觉搜索而非基于文本的替代方案[1]。在16-34岁的用户中,22%通过视觉搜索完成过购买,而55岁及以上用户中这一比例仅为5%[1]。视觉搜索迎合了用户需要即时结果的微时刻[1]。移动用户完全跳过打字,更倾向于拍摄照片获取即时答案。
Google Lens每月处理200亿次搜索
Google Lens每月处理约200亿次视觉搜索[1]。这一规模使Lens查询成为Google上增长最快的查询类型之一[1]。该平台识别超过10亿个物品,并根据特定搜索场景提供定制化结果[2]。
商业意图渗透在这些搜索中。20%的Lens搜索与购物相关[1],而使用Lens的视觉搜索中有四分之一具有商业意图[1]。亚马逊报告全球视觉搜索同比增长70%[2],这表明视觉查询现在直接与传统基于文本的产品发现方式竞争。
Google已将Lens与其购物图谱集成,该图谱包含超过450亿产品的信息[1]。当用户上传照片或实时拍摄时,系统识别物品,显示关键产品信息,展示跨零售商的价格比较,并呈现评论。测试表明,购物者对此界面的参与度高于标准搜索结果[1]。
Lens现在支持多模态查询,允许用户结合视觉输入与语音命令。用户无需先拍摄物体再等待结果,而是可以直接对准摄像头同时询问"这些是什么牌子的运动鞋,在哪里可以买到?"[1]。系统还处理实时视频捕捉,超越了静态图像识别[1]。
AI平台现在同时处理图像、视频和文本
多模态AI指处理并整合多种数据类型(文本、图像、音频和视频)为统一框架的系统[3]。这种集成使AI能够像人类一样分析信息:同时考虑视觉、文本和听觉线索。
Google的Gemini驱动AI跨格式解读语境信号[4]。GPT-4 Vision将视觉理解与自然语言处理相结合[3]。像Claude 3.5 Sonnet这样的系统分析带有图表和图形的财务文档,同时理解语音语调和面部表情中的情感语境[1]。这些能力超越了简单的物体识别,进入了语义理解层面。
医疗应用展示了这一转变。放射科医生使用同时检查医学扫描、阅读患者病史和理解症状描述的系统来生成诊断见解[1]。零售平台采用理解产品图像和关于风格偏好、场合和季节的文本描述的视觉搜索[1]。
多模态AI市场在2024年达到17.3亿美元,预计到2030年将达到108.9亿美元,年复合增长率为36.8%[2]。这一增长反映了LLM搜索如何从文本优先转向格式无关,处理最能捕捉用户意图的任何输入类型。
为什么视觉内容驱动LLM召回和归因
视觉内容不仅仅是LLM搜索中文本的补充——它生成独特的数学信号,决定品牌在AI生成回答中的召回率。理解这些信号的工作原理,就能明白为什么视觉优化现在对AI可见性的塑造作用,与曾经传统SEO对有机排名的塑造作用一样根本。
多模态嵌入如何工作
多模态嵌入创建了一个共享表示空间,图像和文本在其中作为可比较的数学对象存在[1]。视觉编码器通过CNN或Vision Transformers等神经网络处理图像,将特征提取为向量表示[1]。文本编码器同时通过Transformer架构处理语言。在训练过程中,模型通过最小化对应图像-文本对嵌入之间的距离来学习关联它们[1]。
技术突破依赖于对比学习,它训练模型将相关的图像-文本对在向量空间中拉近,同时将不相关的对推远[1]。OpenAI的CLIP模型通过在互联网上训练4亿个图像-标题对,大规模展示了这一点[3]。该模型生成的嵌入中,文本"桌子上的红苹果"比不相关的文本或图像更接近该场景的图像[1]。Meta的ImageBind将这一概念扩展到六种模态——图像、视频、文本、音频、深度和热数据——无需为每种组合提供配对数据[1]。
语义相似性成为组织原则。当用户向LLM查询你的产品类别时,系统将查询向量与索引向量进行比较,使用余弦距离或内积方法基于计算出的相似性检索项目[1]。训练中使用的视觉数据集越丰富,模型对图像和文本语境的理解就越细致[3]。
视觉资产创建语义搜索信号
数字资产管理中的视觉搜索使用图像识别来分析图像中的特征,如物体、场景、颜色、设置和徽标[4]。Vision Transformers将这些特征转换为存储在数据库中的独特特征向量,然后基于视觉相似性对相似图像进行排名和呈现[4]。语义搜索侧重于理解含义和意图,而非关键词匹配[4]。
自然语言处理允许用户使用完整短语进行搜索,例如"找到我们CEO在欧洲会议上微笑的照片",即使确切的词从未出现在元数据中,也能解释语境和关系[4]。同样,AI系统不断从用户搜索和修正中学习,随着时间的推移变得更加准确[4]。采用AI驱动增强的组织每年可节省约575小时的手动元数据工作,相当于约55,000欧元的节省[4]。
图像训练LLM对品牌语境的理解
图像数据集对于训练能够理解视觉信息以执行图像识别、字幕生成和视觉问答等任务的LLM和多模态AI系统至关重要[3]。结合图像和文本数据的多模态模型在需要跨两种模态检索和推理的数据集上比现有模型表现优异10-20%[3]。这一改进展示了整合视觉和文本数据如何使AI模型能够执行复杂的现实世界任务[3]。
图像字幕数据集帮助LLM弥合视觉和文本数据之间的差距,提高图像到文本生成任务的性能[3]。当你的产品图像在预训练阶段与描述性文本一起出现时,LLM会在视觉属性和品牌身份之间建立关联。这些关联持续存在于模型的参数中,影响未来关于你类别的回答。
预训练窗口优势
通过自监督直接从自然语言描述中大规模预训练计算机视觉模型,使模型能够捕获广泛的视觉概念,而无需劳动密集型的手动标注[3]。预训练后,自然语言可以引用已学习的视觉概念或描述新概念,实现对多样化计算机视觉任务的零样本迁移[3]。在LAION-2B的23亿英语图像-文本对上训练的模型在计算机视觉基准测试中实现了卓越的零样本性能[3]。
这为生成引擎优化和AEO策略创造了关键的时间优势。在预训练阶段索引的视觉内容嵌入到模型权重中,在训练结束后长期影响回答。现在优化视觉资产的品牌将在未来模型版本中获得代表性,而延迟视觉优化的竞争对手将完全错过预训练窗口。AI搜索跟踪变得必要,以衡量视觉优化工作是否转化为跨这些系统改进的AI可见性。
AI系统如何从视觉内容中提取意义
现代AI平台通过四种不同的技术能力从图像中提取结构化信息,将视觉资产转化为机器可读数据。
现代LLM中的OCR能力
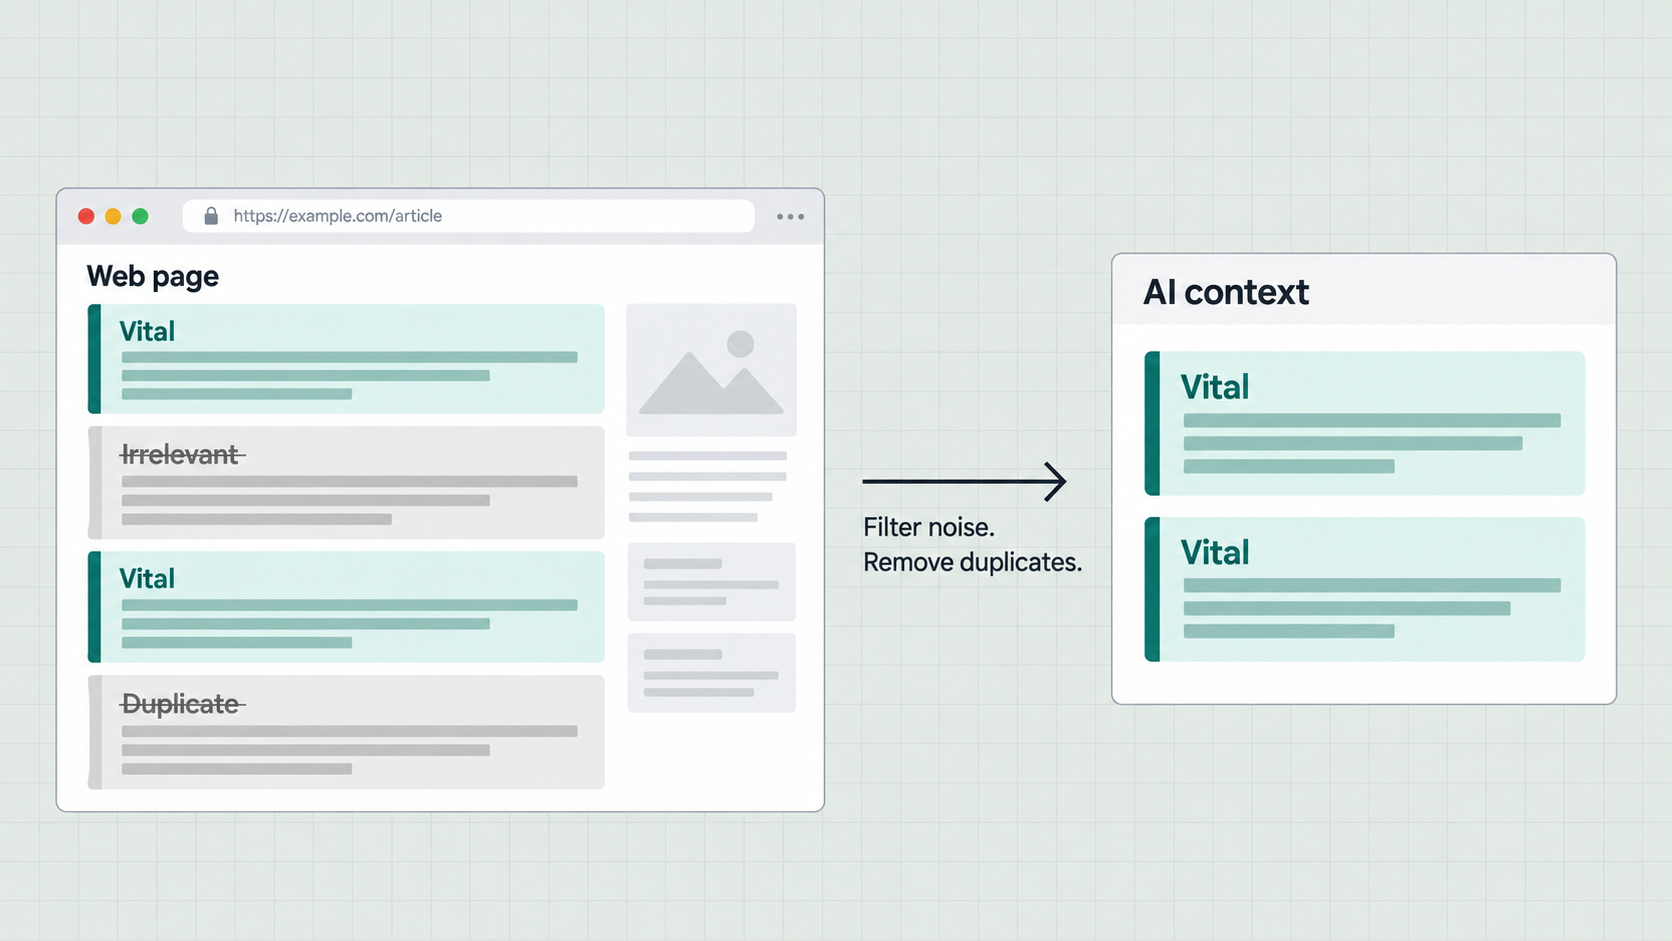
多模态LLM执行光学字符识别的方式与传统引擎不同。基于视觉的模型如GPT-4 Vision和Claude分析图像,接收图像和文本作为输入,使用组合数据回答请求[5]。与使用输出文本供另一个程序解释的独立OCR软件不同,多模态LLM直接摄取文档图像,同时转录和理解内容[6]。
技术区别很重要。传统OCR在字符识别准确性和提供精确位置坐标方面表现出色,但缺乏语义理解[1]。LLM解释语境,通过检查周围文本来解决如区分'O'和'0'的歧义[6]。2024年一项关于历史文档的研究发现,顶级LLM在困难手写体上显著优于最先进的OCR模型,经过适当提示后字符错误率低至1%[6]。
然而,LLM在处理密集或小文本、长数字的数值精度以及不寻常布局方面存在局限性[1]。对于业务关键的工作流程,将专用OCR引擎用于文本识别与LLM用于解释相结合,比单独依赖LLM更安全[1]。
物体检测和语境推理
AI通过分层分析处理图像。图像分类分配一个高级类别标签,回答"主要主题是什么?"[7]。物体检测更进一步,识别出现什么物体以及在哪里出现,围绕每个项目绘制边界框[7]。图像分割创建像素完美的轮廓,定义精确的形状和边界[7]。
视觉-语言模型展示了复杂的语境推理。当呈现掩蔽背景上的单个物体时,VLM推断细粒度场景类别和粗粒度上位语境,如室内与室外设置[8]。当背景语境消失时保持稳定的物体表示更能预测成功的语境推理[8]。
图像情感评分
AI系统通过结合视觉特征编码与结构化知识检索的多模态感知管道分析视觉情感[9]。这些框架建模艺术家、风格、历史时期和文化符号之间的关系,执行基于图表的实体检索以提取语义相关的语境知识[9]。
通过视觉共现建立品牌关联
视觉共现模式训练AI对品牌关系的理解。模型经常使用物体与其语境之间的共现来提高识别准确性[4]。当产品图像在训练期间持续出现在特定语境旁边时,AI会形成持续存在于模型参数中的关联,影响未来LLM搜索结果中的品牌相关回答,并影响整体AI可见性。
使你的视觉内容机器可读
为机器解释优化视觉资产需要在包装设计、排版、元数据结构和图像呈现方面进行精心设计。
为OCR设计包装和产品
电子商务包装在多模态AI搜索环境中充当数字资产。Google Lens和领先的LLM都使用光学字符识别从实体商品中提取、解释和索引数据[3]。OCR以机器可读和人类可读的格式编码信息,与仅机器可读的条形码不同[10]。包装上的产品文字和视觉内容必须支持干净的OCR转换为数据[3]。像Cetaphil这样的品牌将实体产品标签视为着陆页,优先考虑AI系统的清晰度[3]。
使用高对比度、清晰的排版
黑色文字在白色背景上是OCR可读性的黄金标准[3]。关键细节如成分、说明和警告应出现在无衬线字体中,如Helvetica、Arial、Lato或Open Sans,背景为纯色且无干扰图案[3]。避免常见的OCR失败点:低对比度、装饰性或手写字体、繁忙图案、弯曲或皱褶表面,以及反光并破坏文字的亮面材料[3]。高对比度排版在保持跨媒体功能可读性的同时创造戏剧性的视觉冲击[11]。
包含结构化元数据和模式
ImageObject模式向AI系统发出视觉重要性的信号[12]。将Product模式与ImageObject结合,使图像与已识别的概念相关联[12]。以JSON-LD格式放置标记,包含contentUrl、caption和representativeOfPage属性[12]。Google使用contentUrl确定元数据适用于哪个图像,要求至少一个附加属性,如creator、creditText、copyrightNotice或license[13]。
优化图像质量和分辨率
AI放大使用人工智能提高分辨率、清晰度和锐度,同时保留原始特征[14]。现代工具分析照片并在放大过程中添加逼真的细节,保持清晰自然的结果[14]。AI识别特定元素,如面部、文字和建筑物,对每个元素应用专门的增强[15]。
控制产品照片中的相邻物体
AI扫描图像中的每个相邻物体以构建语境数据库[3]。道具、背景和周围元素帮助AI推断价格点、生活方式相关性和目标客户[3]。奢侈品线索、运动装备和实用工具为LLM搜索算法重新校准品牌数字形象[3]。
运行视觉知识图谱审计
建立评估、纠正和操作化品牌语境以进行生成引擎优化的工作流程[3]。共现审计确保AI模型正确映射品牌价值、语境和理想客户,提高高价值对话查询中的AEO性能和AI可见性[3]。AI搜索跟踪衡量视觉优化如何转化为跨多模态平台改进的定位。
视觉优化的竞争影响
品牌在多模态AI环境中面临不对称优势,早期视觉优化创造复合回报,后来者难以匹敌。
训练窗口锁定效应
在预训练阶段索引的视觉内容直接嵌入到模型参数中。一旦训练结束,这些关联在无需持续爬取的情况下持续存在于未来查询中。在训练窗口关闭后优化视觉资产的竞争对手将完全错过该模型版本中的代表性。这创造了时间优势,在主要模型更新之前投资于机器可读图像的品牌获得可见性,这种可见性一直锁定到下一个训练周期。
视觉搜索对有机流量的蚕食
AI平台重新定义了信息的发现方式,一些品牌看着有机流量下滑,而另一些为此渠道优化的品牌则看到流量上升[16]。顶级Google排名不再保证在ChatGPT或Google AI模式结果中的位置[16]。视觉搜索查询现在直接与传统基于文本的发现竞争,分散流量来源,需要同时对生成引擎优化和传统SEO进行并行优化。
AI可见性中的赢家通吃
AI生成回答中的提及比传统排名更能塑造认知和购买意图[16]。标志性品牌通过一致、结构化的可见性信号赢得细分市场[16]。AI搜索跟踪揭示了集中效应,训练数据中的主导视觉存在转化为AI生成推荐的不成比例份额,创造随时间复合的AEO优势。
结论
LLM搜索的视觉优化已不再是可选项。Google Lens每月处理200亿次搜索,多模态AI系统现在对视觉内容的训练强度与对文本的训练一样。由于这一转变,现在优化机器可读图像的品牌获得了持续存在于未来模型版本中的可见性优势。
首先,为OCR可读性设计你的产品摄影、包装和视觉资产。添加结构化模式标记以将图像与已识别的概念连接起来。最重要的是,审计你的视觉知识图谱,以控制AI系统如何将你的品牌与语境、情感和类别定位相关联。视觉搜索可见性随时间复合,因此延迟优化的品牌将失去无法恢复的预训练窗口。
参考文献
[1] - https://www.cradl.ai/posts/llm-ocr
[2] - https://kanerika.com/blogs/multimodal-ai/
[3] - https://searchengineland.com/products-machine-readable-multimodal-ai-search-465151
[4] - https://ai.meta.com/research/publications/dont-judge-an-object-by-its-context-learning-to-overcome-contextual-bias/
[5] - https://penntoday.upenn.edu/news/peek-future-visual-data-interpretation
[6] - https://photes.io/blog/posts/ocr-research-trend
[7] - https://www.zemith.com/blogs/artificial-intelligence-image-analysis
[8] - https://arxiv.org/abs/2603.26731
[9] - https://www.sciencedirect.com/science/article/pii/S2590005625002978
[10] - https://www.automate.org/vision/case-studies/three-ways-to-enhance-packaging-line-performance-with-machine-vision-ocr
[11] - https://www.fontfabric.com/blog/typography-knowledge-contrast-typography/
[12] - https://venngage.com/blog/visual-seo-ai-search/
[13] - https://developers.google.com/search/docs/appearance/structured-data/image-license-metadata
[14] - https://www.adobe.com/products/firefly/features/image-upscaler.html
[15] - https://artsmart.ai/blog/how-to-increase-resolution-of-an-image-with-ai/
[16] - https://searchengineland.com/the-ai-visibility-index-heres-whos-winning-ai-search-463319