从签名身份到信任带:Cloudflare 开始衡量 AI 爬虫是否真的尊重你的站点
从签名身份到信任带:Cloudflare 开始衡量 AI 爬虫是否真的尊重你的站点
驾照能证明一个人是谁、也证明他考过试,但它不能说明这个人明天会怎么开车。Cloudflare 在 2026 年 10 月 16 日的一篇文章里用了大致相同的比喻,然后给出结论:验证爬虫的身份建立了问责的前提,但信任取决于它接下来做什么 [1]。
这篇文章发布了一套新系统:观测一个已验证爬虫的行为是否开始偏离它承诺遵守的规则,并把这些观测变成 Cloudflare 所说的「信任带」[1]。
身份那一半问题,此前已经先解决了。Cloudflare 的 Verified bots 计划现在接受通过 Web Bot Auth 做请求签名,底层是 HTTP 消息签名(RFC 9421),爬虫可以用密码学证明自己是谁,而不只是在请求头里自称 [3][4]。10 月 16 日这篇要处理的,是行为那一半。
对运营站点的人来说,这件事改变了问题本身。常见的 GEO 建议是:在 robots.txt 里按名字放行搜索爬虫、拦掉训练爬虫。这条建议作用在字符串上。而底层设施正在转向「可证明的身份 + 被测量的行为」,而且其中两个被测量的信号,恰恰由你的服务器产生——你的 robots.txt,和你返回的 HTTP 429。
---
先给结论
Cloudflare 的已验证爬虫现在要过两道门槛,而不是一道:诚实地自我标识,以及不滥用它换来的访问权 [2]。
- 身份变成了密码学的。 Web Bot Auth 让爬虫用私钥给每个请求签名,并把公钥发布在一个约定路径上。Cloudflare 在边缘验证签名并把流量标记为已验证,站点随后可以在防火墙和 bot 规则里引用这个标记 [3][4]。
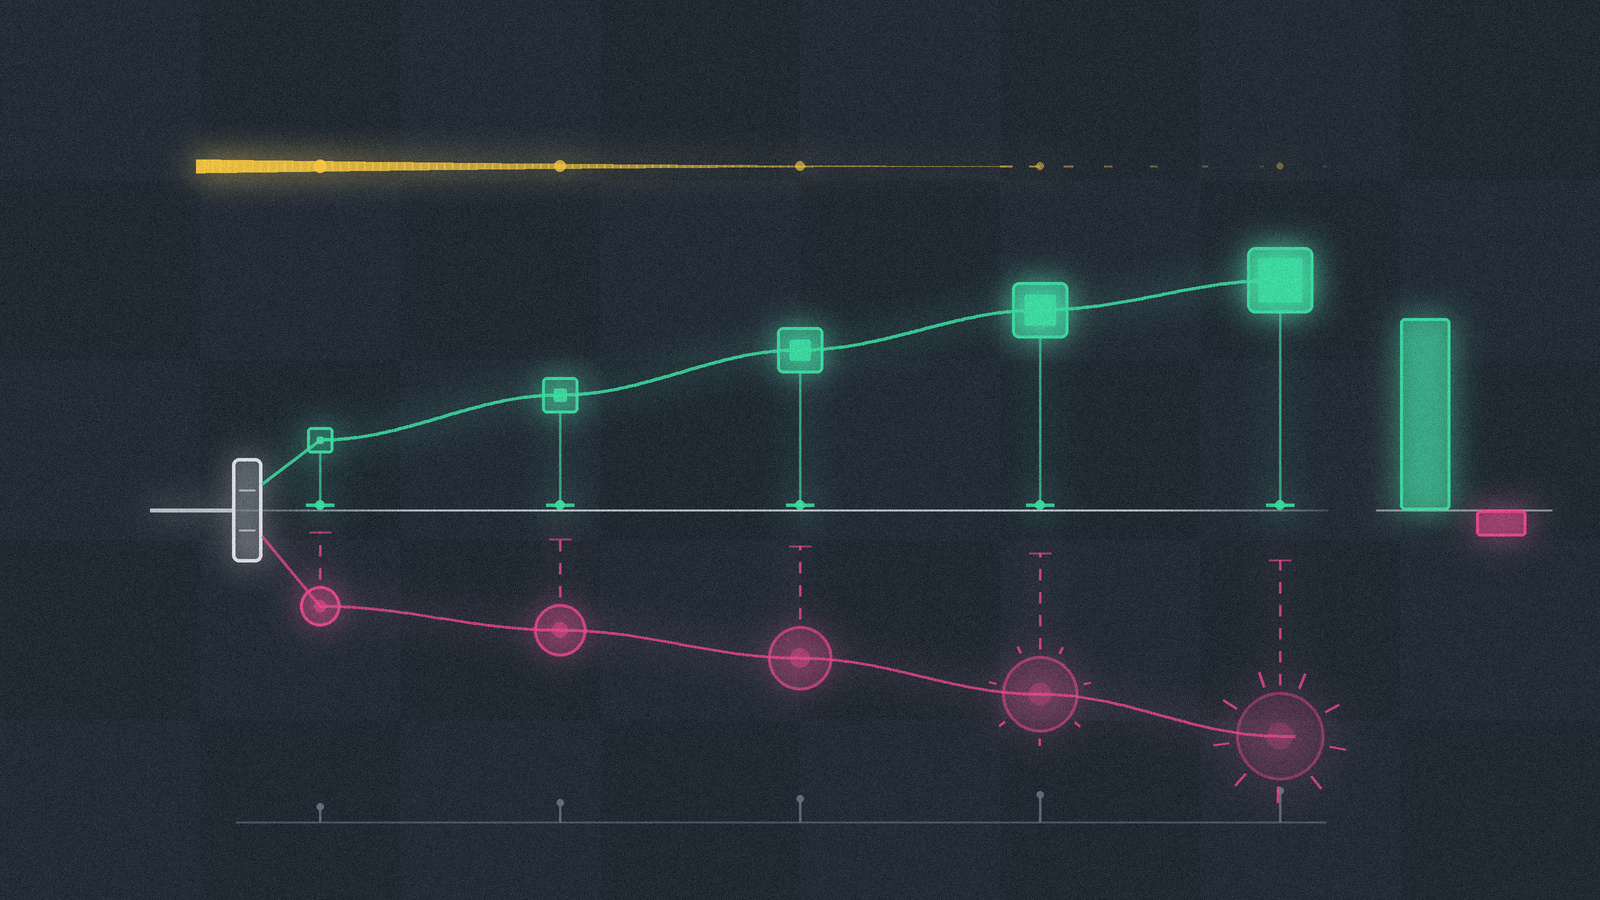
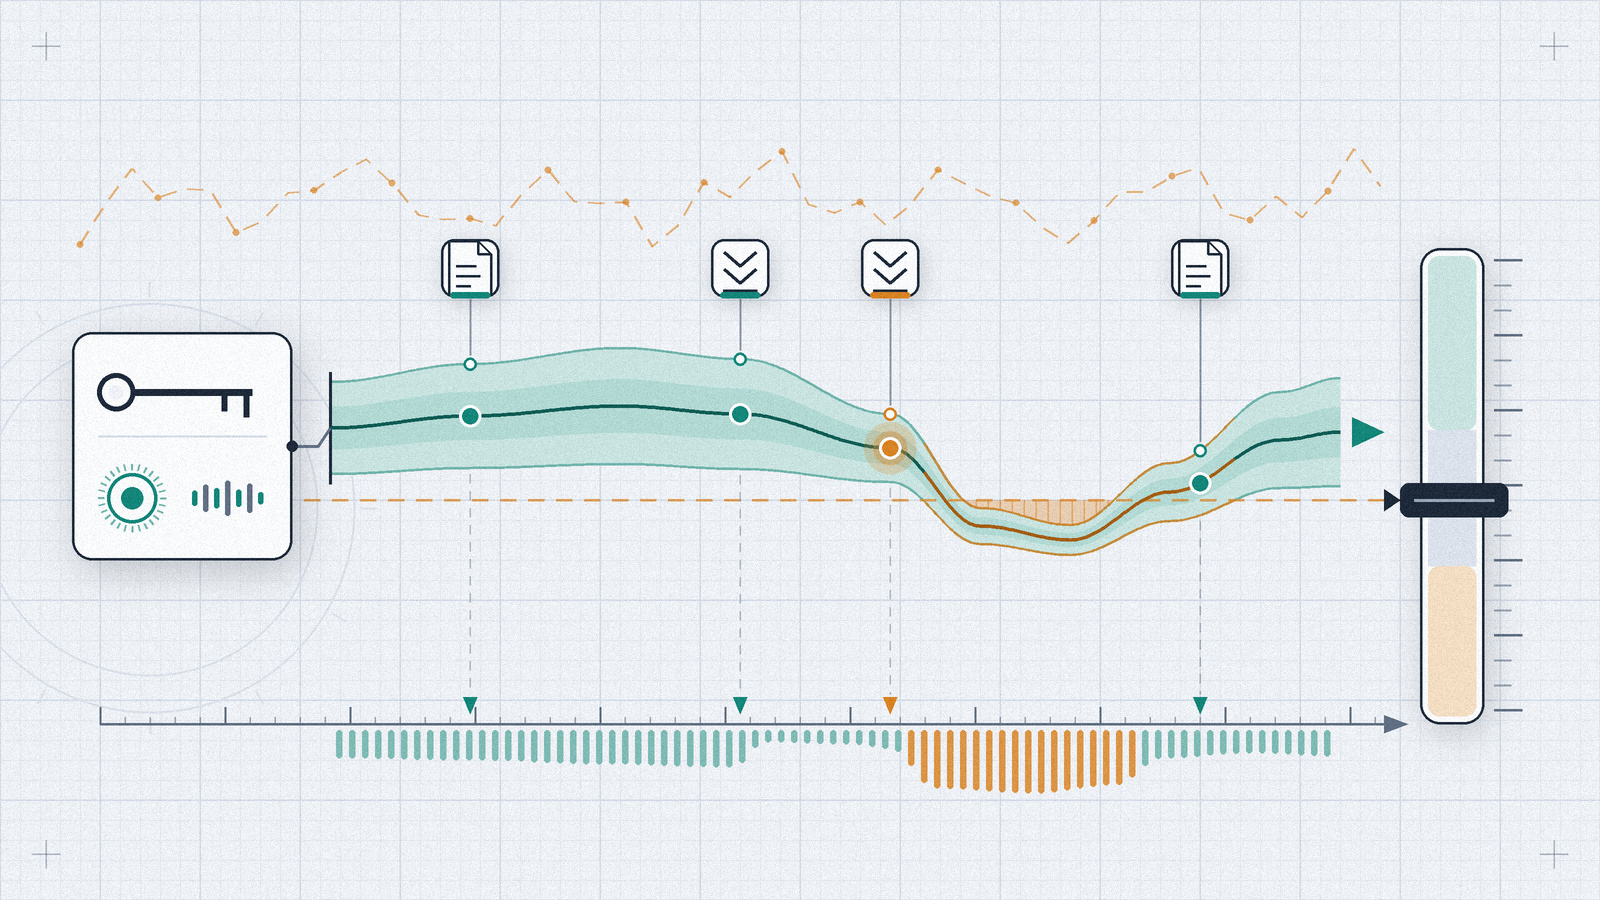
- 行为开始被长期测量。 新系统先看两个信号:爬虫的流量是否与站点公布的偏好长期保持一致,以及它是否对直接反馈做出反应。观测结果汇成一条可解释的信任带——Cloudflare 把它描述为一个区间,附带形成该判断的行为依据,而不是对某个爬虫或运营方的永久判决 [1]。
- 证据由你的服务器产生。 robots.txt 是公布偏好的主要渠道,HTTP 429 则是让爬虫降速最明确的方式。系统会看流量在收到 429 之后是否调整:降速或暂停会积累信任,反复无视会压低信任带 [1]。
还没有发生的事:分数没有公开。Cloudflare 说目前在内部使用这套系统,计划之后发布到 Radar,并计划让客户自己选择判定已验证爬虫流量的信任阈值 [1]。这些都不是行业标准,也没有任何厂商声称信任带会影响 AI 平台是否引用你。
务实的结论比标题更窄,但更有用:你的源站发出的信号,正在变成别人测量体系里的输入,所以值得把它们弄对。
---
为什么身份必须先重建
Cloudflare 自己对旧方法的描述并不客气。过去的验证依赖两个信号:User-Agent 请求头和公布的 IP 段。User-Agent 是客户端自己选的字符串,任何人都能设成任意值。IP 段脆弱的原因不同:同一批地址可能被多个用户、同一家公司的多个服务、甚至共享主机上的多家公司共用,而且这些段会随基础设施变化而改变 [3]。
Cloudflare 提出并已并入 Verified bots 计划的替代方案是:让爬虫在每个请求上证明自己的身份。
一个签名请求是怎么构成的
- 爬虫生成签名密钥,并把含公钥的 JSON Web Key Set 托管在自有域名的
/.well-known/http-message-signature-directory。 - 通过 Verified Bots 表单把这个目录 URL 注册给 Cloudflare,验证方式选「请求签名」。
- 每个外发请求都对目标 URI 的 authority 签名,写入
Signature-Input头,其中包含有效期窗口(created与expires)、作为 JSON Web Key Thumbprint 的keyid,以及值为web-bot-auth的tag。 Signature-Agent头指向密钥目录,而这个头本身也在签名内容之内。
按 Cloudflare 公布的形式简化后的请求头示例:
GET /path/to/resource HTTP/1.1
Host: www.example.com
Signature-Agent: "https://signer.example.com"
Signature-Input: sig=("@authority" "signature-agent");\
                 created=1700000000;\
                 expires=1700011111;\
                 keyid="poqkLGiymh_W0uP6PZFw-dvez3QJT5SolqXBCW38r0U";\
                 tag="web-bot-auth"
Signature: sig=:jdq0SqOwHdyHr9...:
边缘怎么校验
Cloudflare 的验证是一组有序检查 [4]:
| 步骤 | 检查什么 | 为什么重要 |
|---|---|---|
| 1 | Signature、Signature-Input、Signature-Agent 三个头是否存在 | 确认确实尝试了签名 |
| 2 | keyid 是否指向 Cloudflare 已知的密钥 | 把请求对应到已注册的运营方 |
| 3 | 当前时间是否已过 expires | 阻止重放已捕获的请求 |
| 4 | tag 是否为 web-bot-auth | 确认该签名用于 bot 认证 |
| 5 | 按 Signature-Input 列出的组件构造签名基串 | 固定「到底签了什么」 |
| 6 | 用 Ed25519 和指定密钥校验基串与 Signature | 产出身份证明 |
有两个细节对站点方重要。第一,站点方不需要做任何配置:Cloudflare 在边缘完成验证,并把通过的流量标记为已验证,之后可以在 Bot Management 和 WAF 规则里匹配 [4]。第二,任何一步失败时,Cloudflare 会回退到旧的识别方式。Cloudflare 把这称为一种「软降级」,并表示会随系统成熟而收紧 [4]。所以签名身份是置信度的提升,还不是一道硬闸门。
签名也不只存在于 Cloudflare。RFC 9421 是已发布的标准,Cloudflare 提到 OpenAI 用它给 Operator 的请求签名。Web Bot Auth 本身仍是 IETF 的草案工作;截至 Cloudflare 那篇文章,IETF 还在考虑是否为它成立工作组 [3][4]。
---
10 月 16 日那套系统到底在测什么
Cloudflare 把已验证爬虫的约定概括为三条义务:准确且安全地标识自己、只做自己声明会做的事、不做滥用性行为 [1]。签名覆盖了第一条,新系统冲的是后两条。
风险与信任被当作两个不同的量
这篇文章把两个常被混用的概念分开了。风险是单个请求或动作有害的可能性,随时会变;信任则通过反复、一致的行为长期积累 [1]。Cloudflare 此前就阐述过同样的区分:像 CAPTCHA 这类一次性关卡属于风险工具,因为它们不携带历史;而贯穿整个会话的行为评估属于信任工具 [5]。
这个区分正是输出为「带」而不是「通过/不通过」的原因。Cloudflare 把信任带描述为一个区间,表示某个爬虫遵守已公布偏好的一致程度,并附上形成该判断的观测行为,且明确说明它不是对某个爬虫或其运营方的永久判决 [1]。
最初的两个信号
| 信号 | 系统看什么 | 信任带怎么动 |
|---|---|---|
| 爬虫是否遵守指令 | 观测到的流量是否长期与站点 robots.txt 公布的偏好一致,符合 RFC 9309 | 反复无视偏好的模式会压低;孤立的偶发事件可能不计入 |
| 它是否回应直接反馈 | 收到 HTTP 429(降低请求速率的指令)之后流量是否调整 | 持续降速或暂停会抬高;反复无视会压低 |
两条都直接来自那篇文章 [1]。Cloudflare 还指出,一个爬虫完全待在允许的路径里,仍然可能给站点带来可观负载——这正是速率行为要与路径合规分开测量的原因。
后果是有先例的。Cloudflare 在 2025 年把 Perplexity 的爬虫移出已验证列表,原因是发现它访问了已声明退出抓取的站点资源,并在被拦后试图绕过 [1]。当时的报告描述了反复更换 User-Agent、变换来源 ASN,以及 robots.txt 被忽略、有时甚至根本没去取 [6]。
当前状态,说清楚
Cloudflare 表示已在内部运行这套系统,评估已验证爬虫遵守站点偏好的一致程度,并在用这个初期阶段积累历史、打磨「观测如何转化为有用指引」。发布到 Radar、扩展测量维度、开放客户可选的信任阈值,这些都被表述为计划 [1]。
所以:系统是真的,先例是真的,但还不是你现在能调的开关。
---
站点方应该读两遍的那句话
同一篇文章里还有一句关于 robots.txt 的表述,和很多团队使用这个文件的方式相反。Cloudflare 写道:robots.txt 规定的是「爬虫不应做什么」的最低限度,而文件没有提到的内容,并不因此就等于被允许。它给的例子是:文件不需要专门写明爬虫必须停止,因为站点可以通过其他渠道表达「继续访问并不受欢迎」[1]。
由此有两个后果。
如果你在 robots.txt 里精心维护了一份放行名单,并假定「没写的就是默许」,那么负责测量的那一方并不这么理解。而如果你的边缘规则和 robots.txt 说法不一致,你就是在同时公布两套偏好。第二种情况常见到 Cloudflare 专门做了一个功能来处理,下文会讲。
同时也要记住这个文件真实的约束力。Cloudflare 自己的文档写明:robots.txt 的遵守是自愿的,文件表达的是偏好,并不能在技术层面阻止访问,部分运营方会照抓不误 [7]。信任带没有改变这一点,它改变的是「无视这个文件会不会留下可追溯的记录」。
---
403 还是 429:这里最可落地的一个细节
如果有爬虫压垮了你的源站,你返回的状态码现在不只是让请求停下。它决定了你到底有没有传达一条速率指令,以及后续的调整行为能不能被观测到。
Google 对自己这一侧有明确文档。要在短窗口内紧急降低抓取速率(量级是几小时到一两天),就对抓取请求返回 500、503 或 429,而不是 200。当 Google 的抓取基础设施遇到大量这些状态码时,它会在整个主机名层面降低抓取速率,既包括报错的 URL,也包括仍在正常返回内容的 URL;错误减少后会自动把速率提回去 [8]。
对 503 或 429,Google 还会读取 Retry-After 头(定义见 RFC 9110),接受「秒数延迟」或「绝对 UTC 时间」两种写法 [8]:
HTTP/1.1 429 Too Many Requests
Retry-After: 120
HTTP/1.1 503 Service Unavailable
Retry-After: Wed, 21 Oct 2026 07:28:00 GMT
Google 在 2026 年 10 月 9 日重构了这部分指引并补充了 Retry-After 的说明,同时指出对这个头的支持并不是新功能,只是此前写在别处、不好找 [9]。
把两边的来源放在一起,一条实操规则就出来了:
| 响应 | 它告诉爬虫什么 | 对 Cloudflare 速率信号的影响 | 什么时候用 |
|---|---|---|---|
403 Forbidden | 拒绝访问 | 不含速率指令,因此没有可供调整的对象 | 爬虫本就不该拿到的内容 |
429 Too Many Requests | 请求速率过高 | 产生那条「调整与否会被测量」的指令 | 你本来欢迎、但造成负载的爬虫 |
503 Service Unavailable | 服务暂时不可用 | Google 会按主机名降速并自动恢复 | 真实故障与维护窗口 |
429 或 503 加 Retry-After | 速率过高,并给出何时可以重试 | 给爬虫一个明确的恢复时间 | 有意降速时的默认做法 |
200 配空内容或极薄内容 | 一切正常 | 没有任何信号,而且薄页面仍可能被索引 | 不要用 |
一个把所有爬虫问题都用 403 挡掉的团队,确实让流量停了,但没有留下任何「曾经要求降速」的记录。而用 429 加 Retry-After 的团队,既传达了限制,也产生了测量所依赖的证据。
两点提醒。Google 的错误码方案被它自己定位为短期应急手段,而不是常态配置,并且在生效期间会压制整个主机名的抓取 [8]。另外,Cloudflare 的测量覆盖的是其网络上的已验证爬虫;对于未验证或本就不合规的爬虫会怎么反应,它没有给出说法。
---
让公布的偏好和实际执行对上
Cloudflare 的 Bot Preference Sync 之所以存在,就是因为这两层会各说各话。它根据仪表盘里设置的 Search、Agent、Training 策略生成受管的 robots.txt 指令;只有当至少一项策略被设为 Block、Block on pages with ads,或(对 Training)Disallow 时才会写入 [7]。
开启之前值得知道的机制 [7]:
- 如果你的源站已经在提供 robots.txt(以 HTTP 200 确认),Cloudflare 会把受管内容拼在你原有内容之前,合并成一个响应返回。如果没有文件,它会新建一个。
- 把 Training 设为 Disallow 会同时加入受管指令并开启对 AI 训练爬虫的边缘拦截。混合用途爬虫被排除在该边缘拦截之外。 一个同时做搜索和训练的爬虫不会被它拦下。
- 受管内容里包含 Content Signals,一套机器可读的词汇表,共三个字段:
search表示建立搜索索引、返回链接与短摘录;ai-input表示把内容输入模型用于实时回答(例如检索增强生成);ai-train表示训练或微调。 - Cloudflare 正在测试第四个字段
content-use,描述访问之后可以保留和复用什么,取值三种:use=immediate只交互不存储,use=reference可索引、摘录并回链,use=full可概括与复现。目前受管内容带的是use=reference。
生成的受管块大致是这个形状:
# BEGIN Cloudflare Managed content
User-Agent: *
Content-signal: search=yes, ai-train=no, use=reference
Allow: /

User-agent: GPTBot
Disallow: /
# END Cloudflare Managed Content
混合用途被排除这一点值得强调,因为它与 Cloudflare 9 月单独推出的另一个控制项相互关联。那个「禁止 AI 训练」设置正是为「同一个爬虫,既要保留搜索收录、又要拒绝训练」这个场景做的;Cloudflare 表示 Apple、Google、Microsoft 已遵守或承诺在给定期限内遵守 [12]。另外,2026 年 9 月 15 日起新接入 Cloudflare 的域名会拿到新默认值:在展示广告的页面上拦截 Training 和 Agent 行为,Search 仍然放行 [11]。
如果你从没核对过这些规则在你的 zone 上是哪一套在生效,那么你公布的文件和你执行的规则可能已经不一致了。
---
行为标签现在比 User-Agent 精确得多
不再按 User-Agent 字符串写规则的另一个理由是:Cloudflare 的分类已经细得多。同一个爬虫可以带多个行为标签 [2]:
| 行为 | 覆盖什么 |
|---|---|
| Search | 为建立搜索索引或 RAG 数据库而抓取 |
| Agent | 用户指派的代理,代某个人取页面 |
| Training | 为训练或微调模型而抓取 |
| Transact | 代用户结账或完成其他交易动作 |
| Data Collection | 比价抓取、竞争情报、第三方分析 |
| Security Testing | 漏洞扫描与渗透测试 |
| SEO | SEO 抓取、站点审计、无障碍检查 |
| Ads Verification | 广告投放核验与广告欺诈检测 |
| Social / Link Preview | 社交与即时通讯平台的链接预览 |
| Feed Fetching | RSS 阅读器、播客聚合、新闻源抓取 |
| Monitoring & Operations | 可用性监控、webhook、健康检查 |
其中 Search、Agent、Training 在所有套餐上都提供受管预设。站点方可以在 WAF 自定义规则、高级速率限制和 late transform 规则里按 cf.verified_bot_category 过滤,这比匹配 User-Agent 稳定得多 [2][4]。
Cloudflare 还按「怎么被运营」给爬虫打标。Direct 指单一、职能明确的运营方在自有基础设施上运行。Intermediary 指一个代理式服务,可以由大量不同终端用户驱动。第二种会产生传递性信任问题:你可能信任运营方,却对某个具体请求背后的终端用户一无所知。Cloudflare 表示正在试验用 RFC 7239 定义的 Forwarded 头转发终端用户信息,让站点方可以把偏好作用到真正负责的那一方 [2]。
支撑这一切的目录 BotBase,刻意不是一份「获批爬虫名单」。Cloudflare 把它描述为一份涵盖所有已知爬虫与代理的目录,也能收录表现不佳的,并明确表示在其网络上滥用信任应当付出代价——会失去已验证状态 [5][10]。
---
这对 GEO 改变了什么,又没改变什么
| 问题 | 以前 | 现在 |
|---|---|---|
| 爬虫怎么被识别 | 一个 User-Agent 字符串加一段公布的 IP | 在边缘校验的签名,旧方法作为回退 |
| 放行规则写在什么上 | 一个你希望它诚实的名字 | 已验证身份加行为标签 |
| 无视 robots.txt 有代价吗 | 通常没有可观测的代价 | 会累积进信任带,且已有厂商因此丢掉验证状态 |
| 返回 429 能达成什么 | 让一个请求停下 | 声明速率上限,并产生被测量的调整信号 |
| 谁在给谁打分 | 没人系统性地给爬虫打分 | Cloudflare 给爬虫打分;你的站点不被打分 |
| 这些会影响引用吗 | 没有证据 | 仍然没有证据 |
最后一行对任何在卖或在买 GEO 服务的人都最要紧。访问是前提,不是结果。爬虫抓到你的页面之后,还要经过索引、检索、重排、证据选择和生成,才可能出现在答案里,而这些环节没有一个由信任带决定。Google 面向其生成式 AI 功能的指引,把「内容可抓取」列为获得资格的要求,对爬虫评分则没有任何说法。
真正改变的,是你自己那些信号的权重。以前,一个被无视的 robots.txt 只是件没有后果的烦心事;现在它是一项测量的输入,而 Cloudflare 打算把这项测量发布出来,并开放成客户可配置的阈值 [1]。这是一个「把公布的偏好写准」的理由,不是一个「预期会涨流量」的理由。
---
七步自查
| 步骤 | 产出 | 负责人 |
|---|---|---|
| 1. 记录你今天实际公布了什么 | 每个主机名与协议变体实际返回的 robots.txt 原文 | SEO、平台 |
| 2. 记录你今天实际执行了什么 | 影响 bot 流量的边缘、WAF、CDN 与源站规则 | 安全、基础设施 |
| 3. 把两份对账 | 公布偏好与执行规则之间的全部矛盾清单 | SEO、安全 |
| 4. 修正速率响应 | 负载问题用 429 或 503 加 Retry-After;403 只留给真正的拒绝 | 基础设施 |
| 5. 分开决定 Search、Agent、Training | 每种行为一份书面策略,含混合用途这个缺口 | GEO 负责人、法务 |
| 6. 把规则从 User-Agent 上移开 | 在可用处改为基于已验证身份与行为类别的规则 | 安全 |
| 7. 继续观察答案本身 | AI 答案与引用监测,与访问控制相互独立 | GEO、数据分析 |
第一步:记录你真正返回的内容
把所有能解析的变体都取一遍 robots.txt:主域与 www、HTTP 与 HTTPS,以及任何地区性主机名。Cloudflare 社区论坛上有用户反馈,在某些配置下受管指令并未按预期出现,所以要核对实际返回的响应,而不是仪表盘里的设置。
第二步:记录你真正执行的规则
把所有能回应爬虫的层都盘一遍:Cloudflare 的 bot 策略、WAF 自定义规则、速率限制、源站规则,以及应用前面和应用内部的任何东西。对每一条要问的问题是:爬虫在什么条件下会收到哪个状态码。
第三步:对账
把两份清单并排放,标出每一处不一致。robots.txt 允许某个爬虫、而 WAF 用 403 拦掉它,或者受管内容对某个爬虫写了 Disallow、而你的规则照常返回内容,这两种都是对外公布的自相矛盾。如果你启用了 Bot Preference Sync,要确认它正在代你写入哪些指令 [7]。
第四步:修正速率响应
把应对爬虫负载的一律 403 换成 429 加 Retry-After。维护窗口保留 503 加 Retry-After。把 Google 的错误码方案当作短期应急,因为它生效期间会压制整个主机名的抓取速率 [8]。
第五步:把三种行为分开决定
Search、Agent、Training 是三种不同用途,值得分别决策。把每一种的放行范围写下来,并明确记录混合用途爬虫怎么处理——因为 Training 的边缘拦截并不覆盖它们 [7][12]。
第六步:不再按 User-Agent 匹配
在平台支持的地方,把规则建立在已验证身份和行为类别上,而不是字符串 [2]。User-Agent 规则只留作兜底,并且要清楚它可以被任何人设置。
第七步:继续观察答案
访问控制决定爬虫能否抓到你,它不会告诉你 AI 平台在怎么描述你。后者需要单独观测。
---
Innflows 能帮上什么
上面讲的全是基础设施层:谁可以取你的页面、它取的时候守不守规矩。这些都不会告诉你 AI 平台实际上在对用户怎么说你的品牌。
Innflows 跨主流 AI 平台、跨语言监测 AI 答案、引用和品牌提及。围绕一次爬虫策略调整,团队可以用它:
- 在策略变更前记录哪些页面被 AI 答案引用,作为基线;
- 在调整 Training、Agent、Search 策略之后,观察某组页面的引用是否发生变化;
- 在访问规则收紧之后,核对 AI 答案对品牌的描述是否仍然准确;
- 对比策略落地后不同平台对品牌的描述差异。
边界很清楚。Innflows 不读取 CDN 或服务器日志,看不到 Cloudflare 的信任带或已验证状态,也无法告诉你某个具体爬虫是否遵守了你的 robots.txt。它从外部观察公开的 AI 答案。策略变更后引用发生变化,是多次运行之间的关联,不能证明是该策略造成的;任何监测工具都不能保证引用。
---
六个常见误读
1. 「我的站点现在有信任分了。」
信任带打的是爬虫的分。Cloudflare 这套系统评估的是已验证爬虫;你的站点是信号来源,不是被评估的对象 [1]。
2. 「签名身份意味着伪装到此结束。」
签名校验失败时,Cloudflare 会回退到旧方法;它把这称为软降级,并表示打算逐步收紧 [4]。
3. 「信任带会影响 AI 要不要引用我。」
没有任何来源这样讲。引用取决于访问之后很远的检索与生成环节。
4. 「robots.txt 没禁止的就是允许的。」
Cloudflare 明确说的是相反的意思:这个文件设定的是最低限度,它的沉默不授予任何许可 [1]。
5. 「在 Cloudflare 里拦掉 Training 就能挡住全部训练抓取。」
混合用途爬虫被排除在 Training 的边缘拦截之外 [7]。那个单独的「禁止 AI 训练」设置正是为这种情况做的 [12]。
6. 「整个互联网现在都这么运作了。」
这是一家网络的机制。Web Bot Auth 还是 IETF 草案工作,底下已发布的那块是 RFC 9421,而信任带是 Cloudflare 自己的、目前仍在内部 [1][3]。
---
常见问题
Cloudflare 在 2026 年 10 月 16 日到底发布了什么?
一套系统:评估并报告已验证爬虫的行为何时开始偏离计划规则,并由观测到的行为生成一条可解释的信任带。目前在内部运行,发布到 Radar 与开放客户可选阈值都是计划 [1]。
Web Bot Auth 是什么?
一种让爬虫通过给请求做密码学签名来证明身份的方法,底层用的是 RFC 9421 的 HTTP 消息签名。Cloudflare 在边缘校验签名,爬虫把公钥发布在自有域名的约定目录下 [3][4]。
要享受签名校验,我需要做什么吗?
不需要。Cloudflare 在边缘完成校验并把通过的流量标记为已验证,你之后可以在 bot 与防火墙规则里引用它 [4]。
爬虫压垮站点时,该用 403 还是 429?
如果你希望它降速但仍保留访问,用 429 加 Retry-After。403 传达的是拒绝,不含速率指令。Google 的文档写明它会在 500、503、429 上降低抓取速率,并在 503 和 429 上读取 Retry-After [8]。
信任带越高,AI 可见度就越高吗?
没有证据支持。信任带关心的是爬虫是否尊重站点偏好,而不是 AI 平台是否引用某个页面。
有爬虫真的因为行为丢掉验证状态吗?
有。Cloudflare 在 2025 年把 Perplexity 的爬虫移出列表,此前它报告该爬虫访问了已声明退出的站点资源,并在被拦后试图绕过 [1][6]。
robots.txt 现在有强制力了吗?
没有。Cloudflare 的文档仍把遵守描述为自愿,并指出部分运营方会照抓不误 [7]。改变的是:无视它现在可能累积成记录。
---
核心结论
10 月 16 日这次发布,有意思的地方不是打分,而是打分背后的那个承认:证明爬虫是谁,结果是这件事里简单的那一半,而且它并没有回答站点方真正的问题——这个爬虫会不会守规矩。
Cloudflare 的回答是长期测量行为,而且起步的两个信号都由你自己的服务器产生。这让你的 robots.txt 和你的 429 响应有了过去没有的分量,也让「公布的内容」和「执行的规则」之间的矛盾从一个小毛病变成一项负债。
这些都不会让你离「被引用」更近一步。访问从来是前提,不是结果。
先把你能控制的信号写准,再去测量你真正在意的那件事:答案里是怎么说你的。
---
参考来源
[1] - Continuous accountability for Verified bots — Cloudflare,2026 年 10 月 16 日
[2] - Verified bots — Cloudflare bot solutions 文档
[3] - Forget IPs: using cryptography to verify bot and agent traffic — Cloudflare
[4] - Message Signatures are now part of our Verified Bots Program — Cloudflare
[5] - Unveiling good and bad behaviors on the Agentic Internet — Cloudflare
[7] - robots.txt setting 与 Bot Preference Sync — Cloudflare bot solutions 文档
[8] - Reduce the Google crawl rate — Google Search Central
[9] - Google's Crawling Documentation Changelog — Google,2026 年 10 月 9 日条目
[10] - BotBase — Cloudflare bot solutions 文档
[11] - New options to manage AI traffic — Cloudflare changelog
[12] - Have it both ways: stay discoverable in search while disallowing AI training — Cloudflare,2026 年 9 月