AI 是怎么「切」你的内容的:每一次引用背后的检索机制
AI 是怎么「切」你的内容的:每一次引用背后的检索机制
在 AI 搜索里,你已经不再是给一个页面争排名,而是让某一个段落被引用。现代答案引擎不会把整页内容从头读到尾,它会把文档切成一个个小的语义段落——通常在 200 到 500 个 token 之间——把每一段转成向量,再挑出最能回答某个具体子问题的那一段 [1][2]。一个段落之所以被引用,是因为它直接支撑了答案里的某个论点,而不是因为它所在的页面排在前十 [1]。
这一个机制,几乎解释了 GEO 圈里所有「要写自包含段落」的建议。这个建议是对的,但它常常被当成一种文风偏好来讲——而它真正的身份是:检索系统如何切分、向量化、排序你文字的直接结果。这篇文章会一步步拆解检索队列,然后告诉你怎样把段落「工程化」,让它扛得住这套流程。
---
检索队列,一步一步拆
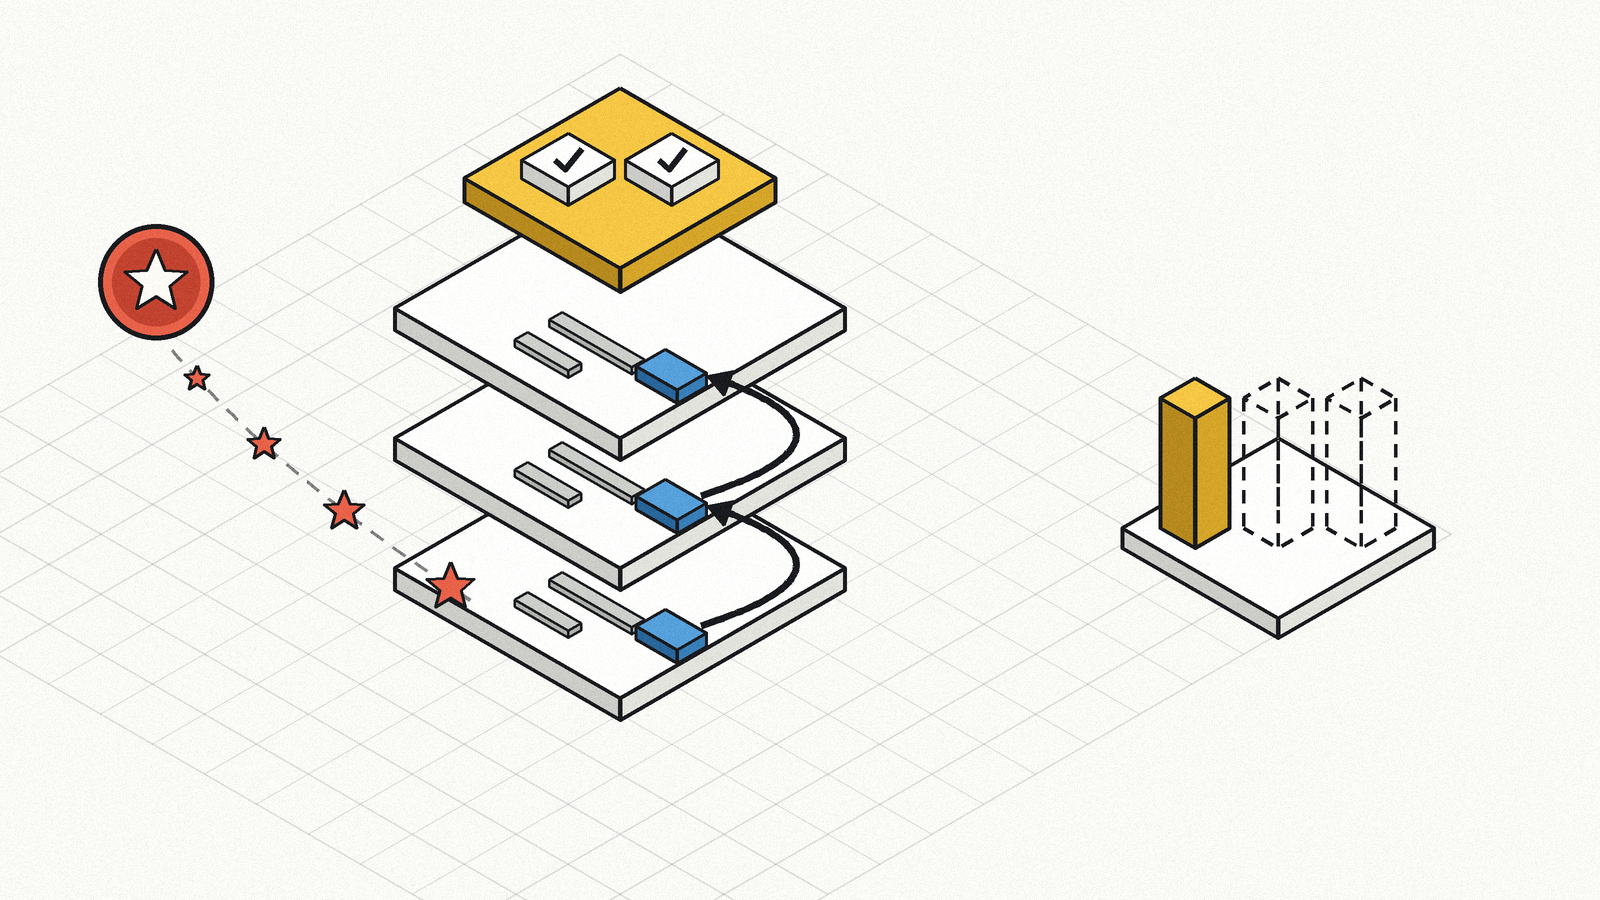
每一次 AI 引用,都是一条「检索增强生成」(RAG)队列的输出。看懂每个环节,你就知道一个段落到底在哪里能赢、在哪里会输。
- 切块(Chunking): 在任何事情发生之前,源文档先被切成更小的单元。怎么切由引擎决定,不由你决定;但你的页面结构,会大幅影响切口落在哪里 [3]。
- 向量化(Embedding): 每一块用一个 embedding 模型转成向量,也就是它含义的数学表示 [4]。
- 建索引(Indexing): 这些向量被存进向量索引,从而可以按「含义」而非「关键词」来检索 [4]。
- 查询与检索(Retrieval): 用户提问时,问题也被转成向量,系统取回与查询向量最接近的 top-k 个块,通常用余弦相似度衡量 [4]。
- 重排(Reranking,可选): 一个二级模型对取回的块重新打分,把最强的提上来、把弱匹配丢掉,再送进模型 [4]。
- 生成(Generation): 存活下来的块被注入模型的上下文窗口,答案据此生成,引用则绑定到真正被用到的那些段落 [7]。
最关键的一点:检索的单位是「块」,不是「页」。 你那篇 3000 字的文章,从来不是作为一个整体去竞争的。它是作为一组被分别评判的段落在竞争,而只有那些能独立成立的段落,才有机会被拉进答案 [5]。
一个段落可能在哪里输掉
| 环节 | 可能出的问题 | 后果 |
|---|---|---|
| 切块 | 一个关键事实被切到两块里 | 两块都无法完整回答子问题 |
| 向量化 | 段落混了好几个主题 | 向量弥散,什么都匹配不准 |
| 检索 | 段落需要前文才看得懂 | 面对独立查询时得分很低 |
| 重排 | 段落把答案埋在营销话术下 | 更干净的竞争者被提上来 |
| 生成 | 段落超出空间预算 | 模型把它裁掉,切走你的关键数据 |
---
为什么「块的大小」决定了什么被引用
块的大小,是这条队列里最关键的变量,而研究对「最佳区间」的结论出奇地一致。
对问答式检索来说,256 到 512 个 token 的块,通常优于更大的块,而事实型查询在这个区间的下端表现最好 [6]。面向内容团队的经验也落在同一区域,把大约 200 到 500 个 token 的语义段落,描述为检索的工作单位 [1]。换算成词而不是 token,实践者们收敛到一个共识:每个自包含段落 50 到 120 词,是可被抽取的区间 [8][9]。
上限之所以重要,是机制问题,不是文风问题。段落一旦超过约 120 词,抽取可靠性就会下降——因为检索模型必须舍弃周围的 token 才能把段落塞进预算,而你最好的那个数据点,可能就在这个过程里被裁掉 [8]。一个又长又流畅的段落,对检索器来说不是「更丰富」,而是「更难干净地安放」,于是它输给了一个把单一意图完整解决掉的短段落。
切块质量对检索的影响,甚至超过模型选择。有分析发现,在同一语料、同一检索器下,切块方法的好坏,可以在召回率上拉开高达 9% 的差距 [3]。你控制不了引擎的切块器,但你能控制自己的内容有没有干净、贴合主题的边界,供它沿着切。
块大小速查
| 单位 | 工作区间 | 来源口径 |
|---|---|---|
| Token(问答检索) | 256–512 | 问答场景优于更大的块 [6] |
| Token(语义段落) | 200–500 | 引擎检索并引用的段落单位 [1] |
| 词(段落) | 50–120 | 自包含、可独立抽取 [8][9] |
---
「重叠」这个迷思
有一条被反复传播的规则说:你应该让块之间重叠 10% 到 20%,以免边界处的上下文丢失。听起来很合理,几乎每一份切块指南都把它当成通用默认值来推荐。
但证据开始质疑它了。2026 年 1 月的一项系统性分析发现,在其测试环境里,块重叠没有带来任何可测量的收益,反而抬高了索引成本 [3]。这不代表重叠永远没用,但确实说明「永远要重叠」这条反射式建议,比业界以为的要脆弱得多。
对内容团队来说,这个结论反而是一种解放:你没法靠指望引擎的重叠,去挽救一个本身无法独立成立的段落。 真正可靠的杠杆,是把每一段都写得自带上下文,而不是依赖它前面那一块。自包含替你干了「重叠本该干」的活,而且这部分,恰恰是你能控制的。
---
研究说,到底什么才会被引用
这个领域被引用最多的学术工作——普林斯顿的 GEO 研究——考察了什么能提升在生成式引擎里的可见度。它发现,收益来自直接对应页面结构的段落级特征:来源引用、富含统计数据的表述、以及可被引用的段落。而不是域名权威,不是字数,也不只是主题相关性 [10]。
这个发现和检索机制完全吻合。一个塞满了具体统计、具名实体和清晰论点的段落,会产生一个锐利的向量,精准匹配某个子问题;而一个满是泛化品牌话术的段落,只会产生一个弥散的向量,什么都匹配不牢。
当段落自带上下文时,检索质量还能大幅提升。Anthropic 的 Contextual Retrieval 研究报告称,配合重排,可以把检索失败率降低多达 67%,在其评测里把失败率从 5.7% 压到 1.9% [3]。对写作者的启示很直接:能自己交代清楚主语和上下文的段落,更容易被正确检索,因为它不依赖那些检索器可能根本不会取回的相邻文字。
---
段落工程:为「块」而写
一旦你接受「块才是竞争单位」,一整套具体的写作动作就随之而来。它们没有一个是装饰性的,每一个都对应队列里的某个环节。
让每个段落自包含
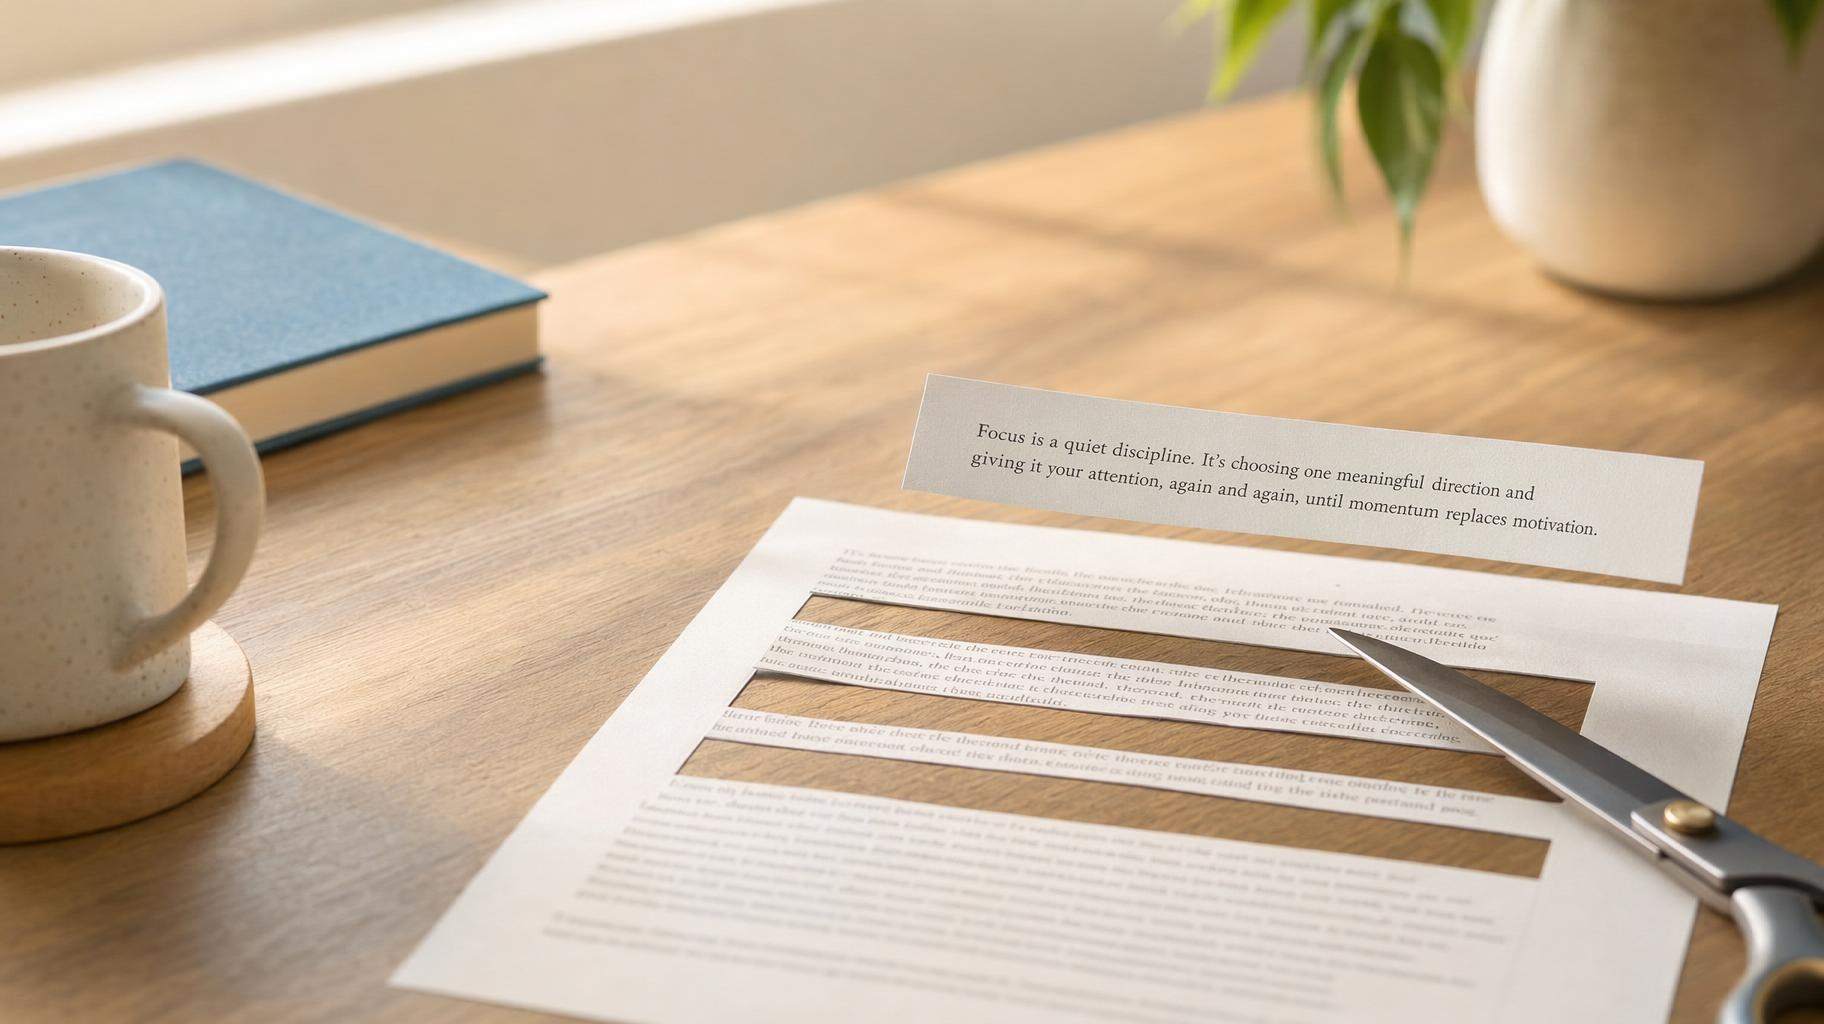
把每一段写成:即使被单独摘出来、粘到一个空白文档里,也依然说得通。明确点出主语,不要依赖「它」「这个」「如上所述」[9]。一个快速自测:把一段从页面里剪下来,单独粘出来,问问它还能不能回答一个问题。如果它需要前一段才成立,那检索器对它的判断,会和你刚才一模一样。
一段只讲一个意图
每一段只解决一个意图。回答单一子问题的段落,会产生一个聚焦的向量,干净地匹配那个子问题;而一段覆盖三个松散相关论点的段落,会把向量摊薄,输给更锐利的竞争者 [1]。
先给答案,再做支撑
把直接答案放在第一句,然后再补证据。检索器和重排器都偏爱那些立刻解决意图的段落,而不是铺垫三句之后才亮出结论的段落 [9]。
尊重长度预算
想被引用的段落,目标控制在大约 50 到 120 词,或 200 到 500 个 token [6][8]。如果一段太长,就在自然的主题边界处拆开,别让关键事实飘到段尾,那里最容易被裁掉。
放进一个可检索的事实
给每个重要段落一个具体的「可匹配点」:一个统计数字、一个具名实体、一个日期、一个明确的流程步骤,或一个具体结果。普林斯顿的发现和向量机制都认同:具体性,正是让一个段落既可被检索、又可被引用的关键 [10]。
用标题对齐主题边界
清晰的 H2、H3 标题,能帮引擎的切块器沿着主题线切,而不是从一个论点中间切开。既然你无法直接控制切块器,结构信号就是你影响「切口落在哪里」的主要手段 [3]。
段落自检清单
| 动作 | 帮到队列的哪个环节 | 为什么有效 |
|---|---|---|
| 段落自包含 | 检索 | 面对独立查询也能得高分 |
| 一段一意 | 向量化 | 产生锐利、可匹配的向量 |
| 答案前置 | 重排 | 比竞争者更早解决意图 |
| 50–120 词 | 生成 | 不超预算、不被裁掉 |
| 含具体事实 | 检索与引用 | 精准匹配子问题 |
| 标题对齐主题 | 切块 | 引导切口落在正确位置 |
---
一个实例对比
设想一个旅行装备品牌可能发布的段落。
改前(叙事型,难以切块):
「我们始终相信,旅行本该毫不费力,这个信念贯穿我们设计的一切。从最初开始,我们的团队就立志重新想象『旅途伴侣』可以是什么样,把风格与一种自由感融合在一起——顾客告诉我们,他们很爱这种感觉。」
这段没点名任何产品、没陈述任何事实、没回答任何问题。它的向量是弥散的,没有任何子问题能匹配上它。
改后(为块而工程化):
「TrailLite 通勤背包重 780 克、容量 22 升,带一个可放 16 英寸笔记本的加垫隔层。它专为日常通勤者设计——想要一个防泼水、又轻到能背一整天的包。」
这个版本点名了实体、以具体规格开头、解决了一个明显的子问题(「适合通勤的轻量笔记本背包」),而且长度舒服地落在预算内。这,才是检索器能安放、模型能引用的那个版本。
---
FAQ
Q:AI 搜索引擎检索的是整页,还是段落?
段落。现代答案引擎把文档切成约 200 到 500 个 token 的语义块,逐块向量化,再取回最匹配某个子问题的那些段落。检索的单位是块,不是页 [1][2]。
Q:段落要多长才容易被引用?
目标大约 50 到 120 词,或约 200 到 500 个 token。超过约 120 词后,抽取可靠性会下降,因为检索器可能裁掉周围 token,才能把段落塞进预算 [6][8]。
Q:块重叠能提高我被引用的概率吗?
不太可靠。2026 年 1 月的一项系统性分析发现,重叠在其测试环境里没有可测收益,还抬高了索引成本。写自包含段落,是比指望引擎重叠更靠谱的杠杆 [3]。
Q:到底什么让一个段落可被引用?
关于生成式引擎可见度的研究指向段落级特征:来源引用、富含统计的表述、可被引用的段落——而不是域名权威或单纯的字数。具体、自包含的段落会产生更锐利的向量,更容易被检索和引用 [10]。
Q:我能控制引擎怎么切我的内容吗?
不能直接控制,但你能影响它。清晰的标题和主题对齐的段落,会促使切块器沿着意图边界切,而不是从一个论点中间切开。结构,是你对「切口落在哪里」的主要杠杆 [3]。
Q:这是不是意味着长文已死?
不是。长文依然有效,但它必须由干净、自包含的段落搭成,而不是流水账式的叙事。一篇 3000 字的页面,如果每一段都能独立成立,就可以非常「可引用」;它失败,是当它读起来像一整段无法被拆解的连续论证时 [5]。
---
核心要点
- 检索的单位是块,不是页。 你的内容是作为一组被分别评判的段落在竞争 [1][5]。
- 每个可引用段落,目标 50–120 词、或 200–500 个 token。 超了,关键事实就有被裁掉的风险 [6][8]。
- 重叠并不是它被吹嘘的那张安全网。 自包含,才是你能控制的可靠杠杆 [3]。
- 具体性取胜。 统计、具名实体、可引用的论点,正对应研究显示的「会被引用」的特征 [10]。
- 结构引导切口。 清晰的标题和一段一意,会把切块器导向主题边界 [3]。
「写自包含段落」从来就不只是一条文风提示。它是那个能扛过切块、产生锐利向量、赢下检索与重排、并塞进生成预算的写作行为。一旦你看清这条队列,每一个段落都变成一个小小的工程决策:当引擎把它单独切下来时,它还能不能独立成立?把答案永远写成「能」,你就是在按 AI 真正的阅读方式写作。
---
参考来源
[1] - How to Rank for GEO and AEO in 2026 — GetGenie
[2] - Retrieval Chunking Architecture — Everything PR
[3] - RAG Chunking Strategies: 2026 Retrieval Quality Playbook — Digital Applied
[4] - How to Build RAG with Embeddings and Vector Search (2026) — TechEarl
[5] - Content Atomization — PromptWatch Glossary
[6] - Best Chunking Strategies for RAG Pipelines (2026) — Fast.io
[7] - How Generative AI Retrieves and Cites Sources — Seography
[8] - How to Score and Optimize Individual Paragraphs for AI Citations — AirOps
[9] - Chunkability for RAG — Rankscale
[10] - How to Structure Content AI Engines Cite — AuthorityTech